<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.9.3">Jekyll</generator><link href="https://cdeguet.net/blog/feed.xml" rel="self" type="application/atom+xml" /><link href="https://cdeguet.net/blog/" rel="alternate" type="text/html" /><updated>2024-04-16T09:42:05+02:00</updated><id>https://cdeguet.net/blog/feed.xml</id><title type="html">Blog de Cyril Deguet</title><subtitle>Le blog de Cyril Deguet
</subtitle><entry xml:lang="fr"><title type="html">Introduction à la Relativité (1ère partie)</title><link href="https://cdeguet.net/blog/relativite/" rel="alternate" type="text/html" title="Introduction à la Relativité (1ère partie)" /><published>2024-04-12T08:00:00+02:00</published><updated>2024-04-12T08:00:00+02:00</updated><id>https://cdeguet.net/blog/relativite</id><content type="html" xml:base="https://cdeguet.net/blog/relativite/"><![CDATA[<ul id="markdown-toc">
  <li><a href="#introduction" id="markdown-toc-introduction">Introduction</a></li>
  <li><a href="#principe-de-relativité" id="markdown-toc-principe-de-relativité">Principe de relativité</a></li>
  <li><a href="#transformation-de-galilée" id="markdown-toc-transformation-de-galilée">Transformation de Galilée</a></li>
  <li><a href="#espace-affine-euclidien" id="markdown-toc-espace-affine-euclidien">Espace affine euclidien</a></li>
  <li><a href="#le-problème-de-la-lumière" id="markdown-toc-le-problème-de-la-lumière">Le problème de la lumière</a></li>
  <li><a href="#transformation-de-lorentz" id="markdown-toc-transformation-de-lorentz">Transformation de Lorentz</a></li>
  <li><a href="#espace-temps-de-minkowski" id="markdown-toc-espace-temps-de-minkowski">Espace-temps de Minkowski</a></li>
  <li><a href="#temps-propre-et-dilatation-du-temps" id="markdown-toc-temps-propre-et-dilatation-du-temps">Temps propre et dilatation du temps</a></li>
  <li><a href="#diagramme-de-minkowski-et-ligne-dunivers" id="markdown-toc-diagramme-de-minkowski-et-ligne-dunivers">Diagramme de Minkowski et ligne d’univers</a></li>
  <li><a href="#cône-de-lumière" id="markdown-toc-cône-de-lumière">Cône de lumière</a></li>
  <li><a href="#composition-des-vitesses" id="markdown-toc-composition-des-vitesses">Composition des vitesses</a></li>
  <li><a href="#quadrivitesse" id="markdown-toc-quadrivitesse">Quadrivitesse</a></li>
  <li><a href="#dynamique-relativiste" id="markdown-toc-dynamique-relativiste">Dynamique relativiste</a></li>
</ul>

<hr />

<h1 id="introduction">Introduction</h1>

<p>La théorie de la relativité, élaborée par le célèbre Albert Einstein (entre autres) au début du XXe siècle, est avec la physique quantique un des piliers de la physique moderne. Tout le monde a déjà entendu parler de la formule \(E=mc^2\) et de l’espace-temps, mais il y a sans doute peu de monde qui soit familier avec les fibrés tangents, le tenseur de Ricci ou encore la connexion de Levi-Civita !
Et pour cause, bien que les principes fondamentaux de cette théorie soient assez simples à comprendre, pour bien en saisir toutes les subtilités il est nécessaire de maîtriser un certain nombre d’outils mathématiques plus ou moins avancés, ce qui peut être rapidement intimidant voire décourageant.</p>

<p>L’objectif de cette Introduction à la Relativité est de présenter les grandes lignes de la théorie de la relativité, restreinte puis générale, en introduisant progressivement les notions mathématiques nécessaires à la compréhension du sujet.</p>

<p>Bonne lecture !</p>

<hr />

<h1 id="principe-de-relativité">Principe de relativité</h1>

<p>Le principe de relativité a été découvert par Galilée au XVIIe siècle, et donc bien avant Einstein. Galilée avait résumé ce principe avec la formule suivante: “le mouvement est comme rien”, affirmation assez mystérieuse qu’il faut expliquer un peu. Galilée avait en effet remarqué que si on est enfermé dans un bateau ayant un mouvement rectiligne uniforme (c’est-à-dire se déplaçant en ligne droite à vitesse constante), il est impossible de se rendre compte que le bateau est en mouvement. Par exemple si on lâche un objet dans le bateau, il tombera à la verticale exactement comme si on était resté à quai. Du point de vue d’un observateur, être immobile sur terre ou immobile dans un bateau (en mouvement rectiligne uniforme) revient donc exactement au même, et d’ailleurs puisque la Terre tourne sur elle-même et autour du Soleil, personne n’est en réalité immobile ! C’est cette constatation qui est à la base du principe de relativité, qui en langage moderne s’énonce comme ceci:</p>

<blockquote>
  <p>Les lois de la physique sont invariantes par changement de référentiel inertiel</p>
</blockquote>

<p>Pour comprendre ce principe, il faut déjà expliquer ce qui signifie un “référentiel inertiel”, aussi appelé référentiel galiléen.</p>

<p>De façon générale, un <em>référentiel</em> est défini par un solide (c’est-à-dire un ensemble de points fixes entre eux) auquel on rattache une coordonnée de temps et un système de coordonnées spatiales, constitué d’un point origine \(O\) et de 3 axes, fixes par rapport au solide de référence. On peut donc par exemple repérer un point \(M\) dans l’espace et le temps par un instant \(t\) et un vecteur \(\vec{r}=\vec{OM}\). Si on se place dans un repère cartésien \((O, \vec{e_x}, \vec{e_y}, \vec{e_z})\), alors on peut repérer le point par 4 coordonnées \((t, x, y, z)\). Il est à noter qu’on peut très bien changer de repère tout en restant dans le même référentiel, du moment que le repère est fixe par rapport au solide de référence. Une remarque importante pour la suite est que dans la physique de Galilée, le temps est <em>absolu</em> et ne dépend pas du référentiel choisi. On peut aussi choisir n’importe quel instant comme origine du temps (c’est-à-dire l’instant \(t=0\)), cela ne change absolument rien aux lois de la physique.</p>

<p>Un référentiel est dit <em>inertiel</em> (ou galiléen) s’il respecte le <em>principe d’inertie</em>, à savoir que dans ce référentiel tout objet qui n’est soumis à aucune force doit avoir un mouvement rectiligne uniforme. En particulier, un objet immobile dans un référentiel inertiel restera immobile s’il n’est soumis à aucune force.
Le bateau dans l’exemple précédent est un référentiel inertiel, tout comme le quai (c’est-à-dire le référentiel terrestre).</p>

<p>La grande idée du principe de relativité est que tous les objets de l’espace sont en mouvement les uns <em>par rapport</em> aux autres, et qu’il n’existe aucun référentiel absolu. Par exemple, un passager est en mouvement par rapport au bateau, le bateau est en mouvement par rapport à la Terre, la Terre est en mouvement par rapport au Soleil, le Soleil est en mouvement dans la galaxie, etc. Par contre, ce que dit Galilée est que si on connait un certain référentiel inertiel \(\mathcal{R}\), alors tout autre référentiel \(\mathcal{R}’\) en mouvement de translation rectiligne uniforme par rapport à \(\mathcal{R}\) est aussi un référentiel inertiel. Par exemple, si le référentiel terrestre est inertiel, alors le référentiel du bateau l’est aussi.
Une autre façon de le dire est que tous les référentiels inertiels sont équivalents, et qu’il n’existe donc pas de référentiel absolu ou privilégié.</p>

<p>Une petite remarque en passant: puisque la Terre tourne sur elle-même et autour du Soleil, le référentiel terrestre n’est en fait pas un référentiel inertiel. On peut considérer que ce référentiel est inertiel uniquement de façon approximative, à moins de faire intervenir des forces fictives dites d’inertie (force d’inertie d’entraînement et force de Coriolis).
De façon générale, tout référentiel en mouvement <em>accéléré</em> (c’est-à-dire dont la vitesse varie en direction et/ou en norme) par rapport à un référentiel inertiel n’est lui-même pas inertiel. Ce n’est pas forcément intuitif, mais la rotation est un cas particulier d’accélération puisque la vitesse de chaque point varie en direction à chaque instant (excepté sur l’axe de rotation).</p>

<p>Pour en revenir au principe de relativité, il faut aussi préciser ce qu’on entend par “invariance par changement de référentiel”. Cela signifie que si on peut écrire une loi de la physique dans un référentiel inertiel donné, cette loi doit s’écrire de la même façon dans un autre référentiel inertiel. L’exemple le plus simple est la loi fondamentale de la dynamique (deuxième loi de Newton) bien connue:</p>

\[m\vec{a} = \vec{f}\]

<p>où \(\vec{f}\) est la somme des forces s’exerçant sur un objet de masse \(m\), et \(\vec{a}\) son accélération dans un certain référentiel inertiel \(\mathcal{R}\).</p>

<p>On peut montrer que si on se place dans un autre référentiel inertiel \(\mathcal{R}’\), cette loi ne change absolument pas et respecte donc le principe de relativité. Pour le démontrer rigoureusement, il faut introduire la <em>transformation de Galilée</em>, que nous allons voir maintenant.</p>

<h1 id="transformation-de-galilée">Transformation de Galilée</h1>

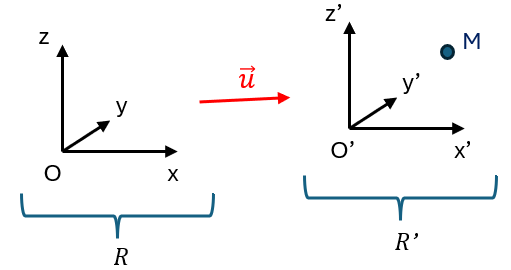
<p>On se donne un certain référentiel inertiel \(\mathcal{R}\), et un autre référentiel \(\mathcal{R}’\) en mouvement rectiligne uniforme par rapport à \(\mathcal{R}\) avec une certaine vitesse \(\vec{u}\), et tels que les repères des deux référentiels coïncident à l’instant \(t=0\).</p>

<p><img src="/blog/images/galilee.png" alt="Changement de référentiel" width="380px" /></p>

<p>La transformation de Galilée est une formule qui permet de calculer les coordonnées \((t’, \vec{r}’)\) d’un objet dans le référentiel \(\mathcal{R}’\) en connaissant ses coordonnées \((t, \vec{r})\) dans \(\mathcal{R}\):</p>

\[\begin{cases}
t' &amp;= t \\
\vec{r}' &amp;= \vec{r} - t\vec{u}
\end{cases}\]

<p>Pour simplifier les calculs, on peut se ramener au cas où \(\vec{u}=u \vec{e_x}\), et dans ce cas la transformation s’écrit:</p>

\[\begin{cases}
t' &amp;= t \\
x' &amp;= x - ut \\
y' &amp;= y \\
z' &amp;= z
\end{cases}\]

<p>Avec cette formule, on peut facilement montrer que la deuxième loi de Newton est identique dans les deux référentiels, et respecte donc bien le principe de relativité:</p>

\[\begin{align}
\vec{r}' &amp;= \vec{r} - \vec{u}t \\
\frac{d\vec{r}'}{dt'} &amp;= \frac{d\vec{r}}{dt} - \frac{d(t\vec{u})}{dt} \\
\vec{v}' &amp;= \vec{v} - \vec{u} \\
\vec{a}' &amp;= \vec{a} \\
m\vec{a}' &amp;= m\vec{a} = \vec{f}
\end{align}\]

<p>Attention, cette démonstration fonctionne uniquement parce que le temps est <em>absolu</em> (et donc invariant par la transformation de Galilée), sinon on ne pourrait pas se permettre de calculer la dérivée par rapport au temps simultanément dans les deux référentiels.</p>

<h1 id="espace-affine-euclidien">Espace affine euclidien</h1>

<p>Avant d’aller plus loin, il est utile de faire un petit détour mathématique en remarquant que dans la théorie de Galilée et Newton, on suppose que l’espace physique est un espace (mathématique) <em>affine euclidien</em>.</p>

<p>Pour le dire simplement, un espace affine est un ensemble de points sur lequel on peut former des <em>vecteurs</em> en reliant un point à un autre. C’est ce qu’on fait toujours depuis le collège, en écrivant par exemple \(\vec{r} = \vec{AB} = \vec{CD}\) ou encore \(\vec{AC} = \vec{AB} + \vec{BC}\) (relation de Chasles). L’idée cachée derrière ces expressions est qu’il y a un sens à parler d’égalité entre des vecteurs définis à des endroits différents de l’espace, ce qui n’a en fait rien d’évident, comme on le verra par la suite.</p>

<p>Pour préciser la définition, un espace affine <em>euclidien</em> est un espace affine dont les vecteurs sont munis d’un <em>produit scalaire</em> \(\langle\cdot,\cdot\rangle\), qui permet de définir des angles et longueurs.
En particulier, une propriété bien connue des espaces euclidiens est le théorème de Pythagore:</p>

\[\langle\vec{a},\vec{b}\rangle = 0 \iff \lVert\vec{a}+\vec{b}\rVert^2 = \lVert\vec{a}\rVert^2 + \lVert\vec{b}\rVert^2\]

<p>où \(\lVert\cdots\rVert\) est la <em>norme euclidienne</em> définie par \(\lVert\vec{v}\rVert^2 = \langle\vec{v},\vec{v}\rangle\).</p>

<p>Là encore, le fait que l’espace physique soit euclidien et donc vérifie le théorème de Pythagore n’a rien d’évident a priori, et la relativité générale montre justement qu’en fait ce n’est pas le cas !</p>

<p>Revenons un instant sur le produit scalaire car ce sera important pour la suite. Dans l’espace \(\mathbb{R}^3\) de la géométrie habituelle, un vecteur \(\vec{v}\) peut se représenter par ses coordonnées \((v^1, v^2, v^3)\). Attention, en relativité on écrit toujours les indices de coordonnées d’un vecteur en <em>haut</em> et non en bas, pour une raison que l’on verra plus loin. Dans ce cas on définit habituellement le produit scalaire par:</p>

\[\langle\vec{a},\vec{b}\rangle = a^1 b^1 + a^2 b^2 + a^3 c^3\]

<p>Mais cette définition est juste un cas particulier; de façon générale, on définit un produit scalaire comme une “forme bilinéaire symétrique définie positive”, c’est-à-dire une application prenant deux vecteurs et retournant un nombre réel, vérifiant les propriétés suivantes:</p>

\[\begin{cases}
\langle\lambda\vec{a} + \vec{b},\vec{c}\rangle = \lambda\langle\vec{a},\vec{c}\rangle + \langle\vec{b},\vec{c}\rangle &amp; \text{(linéaire à gauche)}\\
\langle\vec{a},\lambda\vec{b} + \vec{c}\rangle = \lambda\langle\vec{a},\vec{b}\rangle + \langle\vec{a},\vec{c}\rangle &amp; \text{(linéaire à droite)}\\
\langle\vec{a},\vec{b}\rangle = \langle\vec{b},\vec{a}\rangle &amp; \text{(symétrique)}\\
\vec{a} \neq \vec{0} \implies \langle\vec{a}, \vec{a}\rangle \gt 0 &amp; \text{(définie positive)}
\end{cases}\]

<h1 id="le-problème-de-la-lumière">Le problème de la lumière</h1>

<p>La mécanique de Galilée et Newton a connu de beaux succès pendant deux siècles, et a permis d’expliquer de nombreux phénomènes tels que le mouvement des planètes.</p>

<p>Mais au XIXe siècle, un gros problème est apparu à cause de la théorie de l’électromagnétisme. En effet, les équations de Maxwell qui permettent de calculer le champ électromagnétique (et en particulier la lumière) ne sont pas invariantes par la transformation de Galilée, et donc ne respectent pas le principe de relativité.</p>

<p>A cette époque, on pensait que la lumière se déplace dans un référentiel absolu appelé l’<em>éther</em>, mais si c’était le cas, alors la vitesse de la lumière mesurée par un observateur devrait dépendre du référentiel de cet observateur, plus exactement de sa vitesse par rapport à ce fameux éther. Mais voilà, la célèbre expérience de Michelson et Morley a montré en 1887 que la vitesse de la lumière mesurée sur Terre est toujours la même dans toutes les directions, ce qui contredisait l’existence de l’éther.</p>

<p>Suite à cette expérience, les physiciens Lorentz et Poincaré (qui croyaient toujours en l’existence de l’éther) ont tenté de réconcilier l’électromagnétisme avec le principe de relativité, en remplaçant la transformation de Galilée par une autre transformation appelée <em>transformation de Lorentz</em>, qui est compatible avec les équations de Maxwell tout en respectant le principe de relativité.</p>

<p>Mais c’est Einstein en 1905, avec sa théorie de la relativité restreinte, qui a trouvé une interprétation physique cohérente de la transformation de Lorentz (que Lorentz et Poincaré eux-mêmes n’arrivaient pas vraiment à expliquer), en postulant que l’éther n’existe pas et que les lois de la physique <em>et</em> la vitesse de la lumière sont invariantes dans tous les référentiels inertiels.</p>

<h1 id="transformation-de-lorentz">Transformation de Lorentz</h1>

<p>Tout d’abord un petit point de vocabulaire: en relativité restreinte on appelle <em>événement</em> un point de l’espace à un certain instant. Dans un certain référentiel \(\mathcal{R}\), on peut donc repérer un événement par ses coordonnées \((t, x, y, z)\).</p>

<p>Comme on l’a vu précédemment, la physique de Galilée et Newton fait l’hypothèse que le temps est <em>absolu</em>, c’est-à-dire qu’on peut utiliser le même repère temporel quel que soit le référentiel. En particulier, il est possible de dire que deux événements ont lieu au même instant dans des référentiels différents.</p>

<p>Cette hypothèse nous semble assez intuitive, et pourtant il n’y a aucune raison physique pour que ce soit le cas. Une des clés de la relativité restreinte est donc de ne plus supposer que le temps est absolu, et voir ce que devient la formule de transformation des coordonnées d’un événement quand on passe d’un référentiel inertiel \(\mathcal{R}\) à un autre \(\mathcal{R}’\).</p>

<p>Pour mettre fin au suspense dès maintenant, voici donc cette formule, appelée transformation de Lorentz, dans le cas où \(\mathcal{R}’\) est en mouvement de translation rectiligne uniforme par rapport à \(\mathcal{R}\), à la vitesse \(\vec{u}=u \vec{e_x}\):</p>

<p>Si on pose \(\gamma = \frac{1}{\sqrt{1-u^2/c^2}}\), la transformation de Lorentz peut s’écrire:</p>

\[\begin{cases}
t' &amp;= \gamma\left(t - \frac{ux}{c^2}\right) \\
x' &amp;= \gamma(x - ut) \\
y' &amp;= y \\
z' &amp;= z
\end{cases}\]

<p>\(c=3.10^8 m.s^{-1}\) étant la vitesse de la lumière.</p>

<p>Dans le cas où \(\vec{u}\) est de direction quelconque, la transformation est un peu plus compliquée et s’écrit:</p>

\[\begin{cases}
t' &amp;= \gamma\left(t - \frac{\vec{u}.\vec{r}}{c^2}\right) \\
\vec{r}' &amp;= \vec{r} + (\gamma-1)\left(\frac{\vec{u}.\vec{r}}{u^2}\right)\vec{u} - \gamma t\vec{u}
\end{cases}\]

<p>Si on compare cette formule avec la transformation de Galilée, on voit que la principale différence est l’introduction du facteur \(\gamma\), appelé <em>facteur de Lorentz</em>, dont la valeur dépend de la vitesse du référentiel \(\mathcal{R}’\) par rapport à \(\mathcal{R}\).</p>

<p>On peut voir que si \(u\) est faible par rapport à la vitesse de la lumière, alors \(\gamma\) est proche de 1 et \(ux/c^2\) est proche de 0. Dans ce cas, on retombe (à peu près) sur la transformation de Galilée, qui est donc une approximation de la transformation de Lorentz pour les faibles vitesses.</p>

<p>Inversement, quand \(u\) se rapproche de \(c\), \(\gamma\) tend vers l’infini, ce qui est une façon de voir que \(u\) ne peut pas dépasser la vitesse de la lumière.</p>

<p>Nous reviendrons sur ce point par la suite, mais on voit déjà que dans la relativité restreinte, <strong>le temps dépend du référentiel choisi</strong>, ce qui est une révolution par rapport à la physique de Galilée et Newton !</p>

<p>Historiquement, Einstein avait pu démontrer la formule de transformation de Lorentz en faisant l’hypothèse que la vitesse de la lumière est identique dans tous les référentiels inertiels, mais il existe en fait une autre démonstration beaucoup plus élégante (mais assez laborieuse) se basant uniquement sur les hypothèses suivantes:</p>
<ul>
  <li>l’espace est <em>homogène</em> (invariant par n’importe quelle translation) et <em>isotrope</em> (invariant par n’importe quelle rotation)</li>
  <li>le temps est <em>uniforme</em> (invariant par “translation”, c’est-à-dire changement d’origine)</li>
</ul>

<p>C’est un résultat assez magique, car toute la théorie de la relativité restreinte, y compris l’invariance de la vitesse de la lumière, découle donc directement de ces deux hypothèses simples sur la structure de l’espace et du temps.</p>

<h1 id="espace-temps-de-minkowski">Espace-temps de Minkowski</h1>

<p>Une conséquence de la transformation de Lorentz est que le temps et l’espace ne peuvent plus être considérés indépendamment comme c’était le cas avec le physique de Galilée et Newton. En effet, on voit qu’un changement de référentiel (inertiel) modifie à la fois les coordonnées spatiales <em>et</em> temporelle d’un événement, et qu’il n’y a plus de temps absolu. C’est pourquoi on ne parle plus de l’espace et du temps, mais tout simplement de l’“espace-temps”, qui est un espace à 4 dimensions: 1 dimension de temps et 3 dimensions d’espace. En pratique, on utilise souvent \(ct\) comme coordonnée temporelle au lieu de \(t\), car \(ct\) a la dimension d’une longueur et est donc homogène avec les coordonnées spatiales.</p>

<p>On peut alors se poser la question suivante: quelle est la structure mathématique de cet espace-temps ? Les mathématiciens Poincaré et Minkowski ont apporté une réponse à cette question en remarquant que si on se donne deux “points” de l’espace-temps (autrement dit deux événements) \(\mathbf{E_1}\) et \(\mathbf{E_2}\), il est possible de calculer une quantité appelée <em>intervalle d’espace-temps</em> qui est indépendante du référentiel choisi, autrement dit qui est invariante par la transformation de Lorentz.</p>

<p>Cet intervalle est noté \(\Delta s^2\) et vaut dans le référentiel \(\mathcal{R}\):</p>

\[\begin{align}
\Delta s^2 &amp;= (c t_2-c t_1)^2 - (x_2-x_1)^2 - (y_2-y_1)^2 - (z_2-z_1)^2 \\
&amp;= (c\Delta t)^2 - (\Delta l)^2
\end{align}\]

<p>Il suffit de faire le calcul pour voir que si on change de référentiel (inertiel) et qu’on calcule les coordonnées des deux événements dans le nouveau référentiel grâce à la transformation de Lorentz, la quantité \(\Delta s^2\) ne change pas et est donc bien définie de façon <em>absolue</em>.</p>

<p>On peut voir immédiatement que \(\Delta s^2\) <em>ressemble</em> beaucoup à la norme (au carré) d’un vecteur dans un espace affine euclidien dont les points auraient pour coordonnées \((ct, x, y, z)\), mais avec une différence de taille: il y a un signe \(-\) devant les termes \((x_2^i- x_1^i)^2\), alors que dans un vrai espace affine euclidien on aurait un signe \(+\) pour calculer la norme.</p>

<p>Pour avoir un espace affine, il faut pouvoir définir un vecteur entre deux points (ici deux événements). Si les coordonnées des événements \(\mathbf{E_1}\) et \(\mathbf{E_2}\) sont respectivement \((ct_1, x_1, y_1, z_1)\) et \((ct_2, x_2, y_2, z_2)\), alors on peut définir un vecteur \(\mathbf{u}=\vec{\mathbf{E_1} \mathbf{E_2}}\) à 4 dimensions appelé un <em>quadrivecteur</em>, reliant \(\mathbf{E_1}\) et \(\mathbf{E_2}\), et ayant pour coordonnées \((c t_2-c t_1, x_2-x_1, y_2-y_1, z_2-z_1)\) dans le référentiel \(\mathcal{R}\) (on notera en gras les quadrivecteurs).</p>

<p>En relativité, on numérote habituellement les coordonnées d’espace-temps de \(0\) à \(3\), \(0\) correspondant à la coordonnée temps et \(1\), \(2\) et \(3\) aux coordonnées d’espace. Les coordonnées du vecteur dans un certain référentiel s’écrivent donc \((u^0, u^1, u^2, u^3)\). Par convention, on désigne les indices des coordonnées d’espace-temps par des lettres grecques, donc on note aussi \(u^\mu = (u^0, u^1, u^2, u^3)\). Attention, il ne faut pas confondre \(\mathbf{u}\) qui est le quadrivecteur lui-même, et \(u^\mu\) qui est sa représentation dans un certain référentiel (le quadrivecteur est ce qu’il est, par contre ses coordonnées dépendent du référentiel choisi), même si par abus de notation on peut écrire \(\mathbf{u} = u^\mu\).</p>

<p>Par analogie avec la vraie norme euclidienne, \(\Delta s^2\) est appelé la “pseudo-norme” (en fait la pseudo-norme <em>au carré</em> pour être exact) du vecteur d’espace-temps \(\mathbf{u}\).
On voit facilement que cette pseudo-norme peut être obtenue à partir d’une sorte de produit scalaire (noté \(\eta\)), défini à partir des coordonnées des vecteurs de la façon suivante:</p>

\[\eta(\mathbf{a}, \mathbf{b}) = a^0 b^0 - a^1 b^1 - a^2 b^2 - a^3 b^3\]

<p>A cause des signes \(-\), cette application \(\eta\) n’est pas un vrai produit scalaire car elle n’est pas définie positive (revoir la définition plus haut), même si les physiciens parlent parfois de produit scalaire par abus de langage. Plus formellement, l’application \(\eta\) est une “forme bilinéaire symétrique non dégénérée”, aussi appelée <em>tenseur métrique</em>, ou tout simplement une métrique (on devrait dire “pseudo-métrique” car elle n’est pas positive, mais c’est encore un abus de langage…).</p>

<p>Pour résumer, l’espace-temps est un espace affine de dimension 4, muni d’une (pseudo-)métrique dite de Minkowski. Cette métrique permet de définir une (pseudo-)distance entre deux événements, <em>indépendante</em> du référentiel choisi, et qu’on appelle un intervalle d’espace-temps.</p>

<p>Une conséquence absolument fondamentale et révolutionnaire de l’existence d’une métrique indépendante du référentiel est que <strong>l’espace-temps est absolu</strong>, alors que le temps et l’espace considérés séparément ne le sont pas (en effet la transformation de Lorentz montre que les distances et les durées dépendent du référentiel choisi).</p>

<p>Il y a donc un sens à parler d’un événement de l’espace-temps dans l’absolu, sans préciser le référentiel. Dans l’espace-temps de Minkowski, un référentiel est simplement un repère qui permet d’attribuer des coordonnées d’espace et de temps aux événements, et changer de référentiel revient simplement à choisir des coordonnées différentes.</p>

<h1 id="temps-propre-et-dilatation-du-temps">Temps propre et dilatation du temps</h1>

<p>Un phénomène bien connu expliqué par la relativité restreinte est celui de la “dilatation du temps”: on dit souvent que le temps “ralentit” ou qu’on vieillit “moins vite” quand on voyage rapidement. Ces affirmations sont à nuancer, car le temps en tant que tel n’a pas de vitesse donc ne peut pas vraiment ralentir, et si on dit “moins vite”, il faut toujours préciser par rapport à quoi.</p>

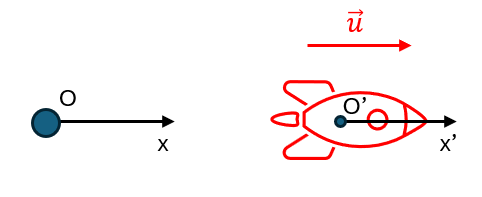
<p>Pour préciser ce qu’est la dilatation du temps, imaginons une fusée partant de la Terre (représentée par un point \(O\)) et voyageant à la vitesse \(u\) constante dans la direction de l’axe \((Ox)\). Dans ce scénario, on peut négliger les coordonnées \(y\) et \(z\), donc on se ramène à un espace-temps à 2 dimensions \(t\) et \(x\), ce qui ne change rien à l’explication. Nous avons donc un référentiel \(\mathcal{R}\) lié à la Terre, et un référentiel \(\mathcal{R}’\) lié à la fusée. Pour simplifier, on suppose que ces référentiels coïncident lors du décollage de la fusée, à l’instant \(t=t’=0\).</p>

<p><img src="/blog/images/fusee.png" alt="Fusée" width="350px" /></p>

<p>Supposons que Bernard voyage dans la fusée tandis que son frère jumeau Alain reste sur Terre, et que la fusée décolle le jour de leur 30ème anniversaire.</p>

<p>On considère les événements suivants \(\mathbf{E_1}\) et \(\mathbf{E_2}\):</p>
<ul>
  <li>\(\mathbf{E_1}\): Bernard quitte la Terre, donc à l’instant \(t_1=t’_1=0\)</li>
  <li>\(\mathbf{E_2}\): Bernard fête son 31ème anniversaire, à l’instant \(t’_2=\tau=1\text{ an}\)</li>
</ul>

<p>Comme on l’a vu, ces deux événements existent de façon absolue dans l’espace-temps, mais ont des coordonnées différentes dans \(\mathcal{R}\) et \(\mathcal{R}’\):</p>
<ul>
  <li>\(\mathbf{E_1}\) a pour coordonnées \((0, 0)\) dans les deux référentiels (par construction)</li>
  <li>Dans \(\mathcal{R}’\), \(\mathbf{E_2}\) a pour coordonnées \((c\tau, 0)\), puisque \(x’_2=0\) (Bernard reste toujours immobile par rapport à la fusée)</li>
  <li>Dans \(\mathcal{R}\), \(\mathbf{E_2}\) a pour coordonnées \((ct_2, x_2) = (c\gamma\tau, u\gamma\tau)\), par application de la transformation de Lorentz</li>
</ul>

<p>Si on calcule l’intervalle d’espace-temps entre \(\mathbf{E_1}\) et \(\mathbf{E_2}\), on trouve:</p>

\[\begin{cases}
\Delta s^2 &amp;= c^2 \gamma^2\tau^2 - u^2\gamma^2\tau^2 = c^2\tau^2\gamma^2\left(1 - \frac{u^2}{c^2}\right) = (c\tau)^2 \text{ dans }\mathcal{R} \\
\Delta s^2 &amp;= (c\tau)^2 \text{ dans }\mathcal{R}' \\
\end{cases}\]

<p>et donc comme prévu, l’intervalle est bien le même dans les deux référentiels.</p>

<p>Cet exemple montre que pour le <em>même</em> événement, il s’est écoulé 1 an pour Bernard depuis son départ, alors que dans le référentiel d’Alain il s’est écoulé \(\gamma\) ans, c’est-à-dire un temps plus long puisque \(\gamma\) est toujours \(\ge 1\) (par exemple si \(u=c/2\), alors \(\gamma\tau\) vaut environ 1 an et 2 mois).</p>

<p>Par définition, on appelle <em>temps propre</em> (noté \(\tau\)) de Bernard le temps mesuré dans “son” référentiel, c’est-à-dire un référentiel dans lequel il est immobile (ici \(\mathcal{R}’\)). De même la <em>durée propre</em> \(\Delta\tau\) est l’intervalle de temps propre entre deux événements. On voit ici que si on mesure le temps dans un autre référentiel que celui de Bernard (par exemple dans celui d’Alain), la durée entre deux événements le concernant est toujours plus grande que la durée propre. C’est en ce sens qu’on parle de “dilatation du temps” de Bernard vu depuis le référentiel d’Alain.</p>

<p>D’ailleurs la situation est totalement symétrique. Ainsi, si on considère maintenant l’événement \(\mathbf{E_3}\) “Alain fête son 31ème anniversaire” (donc à \(t_3=\tau\) et \(x_3=0\)), il s’est aussi écoulé un temps plus long (\(\gamma\tau\)) dans le référentiel de Bernard ! Cela peut sembler paradoxal, car si le temps de Bernard passe moins vite que celui d’Alain, comment le temps d’Alain peut-il aussi passer moins vite que celui de Bernard ? En fait il n’y a aucun paradoxe, mais pour s’en convaincre il est utile d’étudier la représentation graphique de l’espace-temps, appelée diagramme de Minkowski.</p>

<h1 id="diagramme-de-minkowski-et-ligne-dunivers">Diagramme de Minkowski et ligne d’univers</h1>

<p>L’espace-temps étant de dimension 4, il est assez difficile de s’en faire une représentation intuitive, d’autant plus que ce n’est même pas un espace euclidien !
Une solution est de se limiter à une dimension d’espace (\(x\)) comme dans l’exemple précédent, et d’utiliser un <em>diagramme de Minkowski</em> qui est une représentation à 2 dimensions de l’espace-temps. Pour cela, il faut d’abord choisir un référentiel inertiel quelconque, et représenter en abscisses la coordonnée d’espace \(x\) dans ce référentiel, et en ordonnées la coordonnée de temps \(ct\). On représente aussi la droite d’équation \(x=ct\) qui matérialise la vitesse de la lumière.</p>

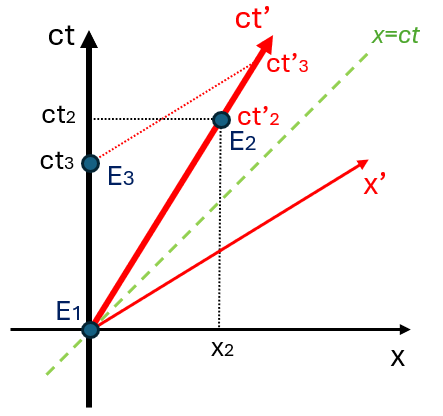
<p>Si on choisit \(\mathcal{R}\) comme référentiel, on peut alors représenter les événements de l’exemple précédent sur le diagramme grâce à leurs coordonnées \((ct,x)\):</p>

<p><img src="/blog/images/minkowski1.png" alt="Diagramme de Minkowski" width="300px" /></p>

<p>Ce diagramme contient beaucoup d’informations que l’on va détailler.</p>

<ul>
  <li>La droite \((\mathbf{E_1} \mathbf{E_3})\) d’équation \(x=0\) (c’est-à-dire l’axe (\(ct\))) représente la trajectoire d’Alain dans l’espace-temps, et est appelée la <em>ligne d’univers</em> d’Alain.</li>
  <li>De même, la droite \((\mathbf{E_1} \mathbf{E_2})\) d’équation \(x=ut\) représente la trajectoire de Bernard, et est donc sa ligne d’univers. Cette droite représente aussi l’axe du temps (\(ct’\)) dans le référentiel \(\mathcal{R’}\), c’est-à-dire la droite d’équation \(x’=0\).</li>
  <li>On a aussi représenté l’axe de l’espace (\(x’\)) du référentiel \(\mathcal{R’}\), c’est-à-dire la droite d’équation \(t’=0\).</li>
</ul>

<p>Le diagramme de Minkowski permet donc de représenter plusieurs référentiels sur le même schéma; on a ici en noir le référentiel \(\mathcal{R}\) et en rouge le référentiel \(\mathcal{R}’\), et on peut facilement voir quelles sont les coordonnées d’un événement dans un certain référentiel en projetant le point correspondant sur les axes de ce référentiel.</p>

<p>Mais il faut faire très attention, car encore une fois, l’espace de Minkowski n’est pas euclidien, et donc sa géométrie est un peu particulière ! En particulier, deux axes orthogonaux dans l’espace-temps (ce qui est le cas des axes de temps et d’espace dans un référentiel inertiel) ne sont <em>pas</em> perpendiculaires sur le diagramme de Minkowski, mais <em>symétriques</em> par rapport à la droite d’équation \(x=ct\) !</p>

<p>De même, il ne faut pas penser que l’intervalle d’espace-temps entre deux événements est représenté par la distance (euclidienne) entre les points correspondants sur le diagramme, car dans la métrique de Minkowski, la “longueur” de la composante spatiale d’un vecteur est comptée <em>négativement</em>. Par exemple, l’intervalle d’espace-temps entre \(\mathbf{E_1}\) et \(\mathbf{E_2}\) est exactement le même qu’entre \(\mathbf{E_1}\) et \(\mathbf{E_3}\) (et est égal à \(\Delta s^2 = (c\tau)^2\) comme on l’a vu précédemment), alors que ce n’est pas évident en regardant le diagramme.</p>

<p>Malgré ces quelques limitations, le diagramme de Minkowski permet de bien visualiser l’effet d’un changement de référentiel et le phénomène de “dilatation” du temps. On voit bien en effet que l’événement \(\mathbf{E_2}\) projeté dans le référentiel \(\mathcal{R}\) est “au-dessus” de l’événement \(\mathbf{E_3}\), ce qui traduit le fait que dans son référentiel propre, Alain fête son anniversaire “avant” celui de Bernard, alors que dans le référentiel \(\mathcal{R}’\) c’est exactement l’inverse: l’événement \(\mathbf{E_3}\) est “au-dessus” de \(\mathbf{E_2}\) et donc dans son référentiel Bernard fête aussi son anniversaire “avant” celui d’Alain !
Il n’y a donc pas de paradoxe, mais ce que montre le diagramme c’est qu’en relativité restreinte il n’y a aucun sens à parler d’“avant”, “après”, ou “en même temps” pour comparer \(\mathbf{E_1}\) et \(\mathbf{E_2}\).</p>

<p>Au passage, le diagramme de Minkowski montre aussi qu’un objet se déplaçant en ligne droite à vitesse constante dans un référentiel inertiel (c’est-à-dire soumis à aucune force) parcourt une <strong>ligne droite dans l’espace-temps</strong>, quel que soit le référentiel choisi.
Ce n’est pas le cas d’un objet soumis à une accélération, qui dans ce cas parcourt une courbe dans l’espace-temps, même s’il se déplace en ligne droite dans l’espace. C’est un point fondamental sur lequel on reviendra en étudiant la relativité générale.</p>

<h1 id="cône-de-lumière">Cône de lumière</h1>

<p>Une notion que nous n’avons pas encore abordée est celle de <em>genre</em> d’un intervalle d’espace-temps. On dit que l’intervalle \(\Delta s^2\) entre deux événements \(\mathbf{E_1}\) et \(\mathbf{E_2}\) est:</p>
<ul>
  <li>de genre “temps” si \(\Delta s^2 \gt 0\)</li>
  <li>de genre “espace” si \(\Delta s^2 \lt 0\)</li>
  <li>de genre “lumière” si \(\Delta s^2 = 0\)</li>
</ul>

<p>D’un point de vue physique, l’intervalle est de genre temps s’il existe un référentiel dans lequel \(\mathbf{E_1}\) et \(\mathbf{E_2}\) ont lieu au même endroit, et de genre espace s’il existe un référentiel dans lequel ils ont lieu au même instant. Enfin, l’intervalle est de genre lumière si on peut relier \(\mathbf{E_1}\) et \(\mathbf{E_2}\) par un rayon lumineux.</p>

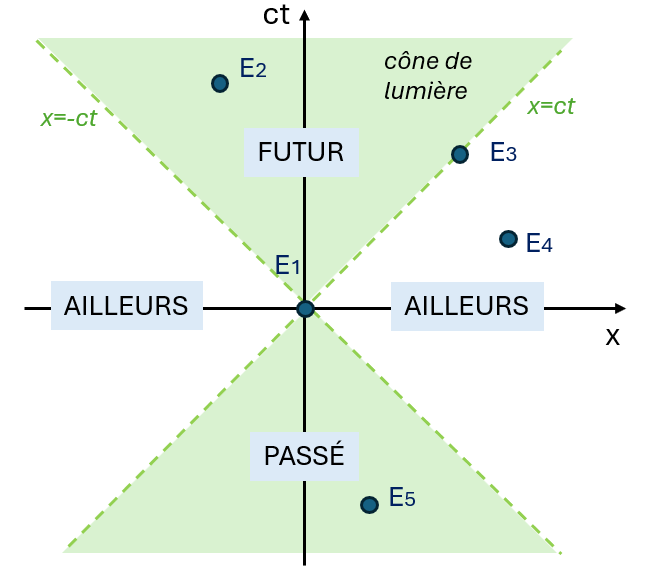
<p>On peut visualiser les différents genres d’intervalles sur un diagramme de Minkowski:</p>

<p><img src="/blog/images/minkowski2.png" alt="Cône de lumière" width="400px" /></p>

<p>Ce diagramme représente ce qu’on appelle le <em>cône de lumière</em> centré sur l’événement \(\mathbf{E_1}\), qui est la zone délimitée par les trajectoires des rayons lumineux passant par \(\mathbf{E_1}\) (c’est-à-dire les droites d’équation \(x=\pm ct\)). L’intérieur du cône de lumière représente l’ensemble des événements pouvant être reliés à \(\mathbf{E_1}\) par un intervalle de genre temps, et est constitué de deux parties: le cône de lumière du <em>futur</em> (du côté \(ct\gt 0\)) et celui du <em>passé</em> (du côté \(ct\lt 0\)).</p>

<p>Ici, \(\mathbf{E_2}\) est donc situé dans le futur de \(\mathbf{E_1}\), et \(\mathbf{E_5}\) dans son passé. Dans ce cas, il y a bien un sens à dire que \(\mathbf{E_2}\) a lieu après \(\mathbf{E_1}\) et \(\mathbf{E_5}\) avant \(\mathbf{E_1}\), et ce dans n’importe quel référentiel.</p>

<p>L’extérieur du cône de lumière est appelé l’<em>ailleurs</em>, et représente l’ensemble des événements pouvant être reliés à \(\mathbf{E_1}\) par un intervalle de genre espace, par exemple \(\mathbf{E_4}\). Les événements ayant lieu dans l’ailleurs sont physiquement inaccessibles par \(\mathbf{E_1}\), car il faudrait dépasser la vitesse de la lumière pour les atteindre. Ces événements n’ont lieu ni avant, ni après \(\mathbf{E_1}\), mais juste… ailleurs.</p>

<h1 id="composition-des-vitesses">Composition des vitesses</h1>

<p>Supposons maintenant que Bernard lance un objet dans la fusée, à une vitesse \(\vec{v}’\) dans son référentiel \(\mathcal{R’}\). Quelle sera la vitesse de l’objet \(\vec{v}\) dans le référentiel d’Alain \(\mathcal{R}\) ?</p>

<p>Dans la relativité de Galilée, la loi de composition des vitesses est simplement \(\vec{v} = \vec{v}’ + \vec{u}\), mais en relativité restreinte, cette loi n’est plus valable car les coordonnées d’espace <em>et</em> de temps dépendent du référentiel.</p>

<p>Dans le cas où \(\vec{v}\) et \(\vec{u}\) sont colinéaires, la transformation de Lorentz montre que la loi de composition des vitesses devient:</p>

\[v = \frac{v' + u}{1 + \frac{v'u}{c^2}}\]

<p>En particulier, cette loi montre que si \(v’=c\) alors on obtient toujours \(v=c\), et donc on retrouve bien que la vitesse de la lumière est invariante par changement de référentiel !</p>

<h1 id="quadrivitesse">Quadrivitesse</h1>

<p>A ce stade, on sait qu’un événement est défini de façon absolue dans l’espace-temps par un quadrivecteur dit <em>temps-position</em>, noté \(\mathbf{r}\). Dans un certain référentiel inertiel \(\mathcal{R}\), ce quadrivecteur peut se représenter par ses coordonnées \((ct, x, y, z)\), qu’on peut aussi écrire \((ct, \vec{r})\) en le décomposant en une partie temporelle et une partie spatiale.</p>

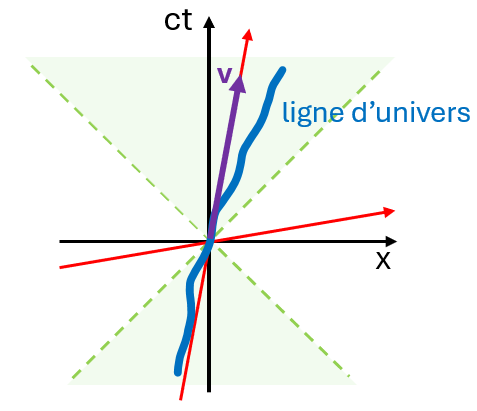
<p>De même, si on considère un objet en mouvement quelconque, on peut définir dans l’espace-temps son <em>quadrivecteur vitesse</em>, aussi appelé <em>quadrivitesse</em>, égal à:</p>

\[\mathbf{v} = \frac{d\mathbf{r}}{d\tau}\]

<p>\(\tau\) étant le <em>temps propre</em> de l’objet, c’est-à-dire le temps mesuré dans un référentiel lié à l’objet lui-même.</p>

<p>Sur un diagramme de Minkowski, la quadrivitesse en un certain événement est un vecteur tangent à la ligne d’univers de l’objet au point en question (le temps propre \(\tau\) correspondant à l’abscisse curviligne de l’objet sur sa ligne d’univers, c’est-à-dire sa position sur la courbe):</p>

<p><img src="/blog/images/quadrivitesse.png" alt="Quadrivitesse" width="300px" /></p>

<p>A partir de la transformation de Lorentz, on peut montrer que dans le référentiel \(\mathcal{R}\), les coordonnées de la quadrivitesse sont:</p>

\[v^\mu = \left(\gamma c, \gamma\frac{dx}{dt},\gamma\frac{dy}{dt},\gamma\frac{dz}{dt}\right) = (\gamma c,\gamma \vec{v})\]

<p>avec \(\vec{v}=\frac{d\vec{r}}{dt}\) et \(\gamma(v)=\frac{1}{\sqrt{1-v^2/c^2}}\).</p>

<p>On remarque que même si les coordonnées de la quadrivitesse dépendent du référentiel, sa norme (de Minkowski) est invariante par changement de référentiel et vaut toujours \(\eta(\mathbf{v}, \mathbf{v}) = c^2\). D’une certaine façon, on peut donc dire qu’objet se déplace toujours “à la vitesse de la lumière” dans l’espace-temps.</p>

<p>Bien que la vitesse dans l’espace soit <em>relative</em> au référentiel, la quadrivitesse est donc, elle, bien définie de façon <em>absolue</em> dans l’espace-temps de Minkowski.</p>

<h1 id="dynamique-relativiste">Dynamique relativiste</h1>

<p>Maintenant, voyons ce que devient la loi fondamentale de la dymamique de Newton. En physique classique, si on considère un corps de masse \(m\) soumis à une force \(\vec{f}\), alors on peut écrire cette loi sous la forme:</p>

\[\frac{d\vec{p}}{dt} = \vec{f}\]

<p>où \(\vec{p}=m\vec{v}\) est la <em>quantité de mouvement</em> du corps en question.</p>

<p>Mais en relativité restreinte, la transformation de Lorentz montre que cette équation n’est <em>pas</em> invariante par changement de référentiel, et donc que cette loi ne respecte plus le principe de relativité (alors que c’était le cas en relativité galiléenne).</p>

<p>A partir de la loi de composition des vitesses, on peut montrer que la loi fondamentale de la dynamique fonctionne bien si on prend comme nouvelle définition de la quantité de mouvement:</p>

\[\vec{p} = \gamma m \vec{v}\]

<p>où \(m\) est la masse du corps au repos et \(\gamma(v)\) le facteur de Lorentz habituel.</p>

<p>Avec cette définition, \(\vec{p}\) dépend bien sûr du référentiel choisi. Mais de la même façon que pour la position et la vitesse, on peut se demander s’il existe un existe un équivalent de la quantité de mouvement dans l’espace-temps, qui serait invariant par changement de référentiel.</p>

<p>Et effectivement, par analogie avec la quadrivitesse, on peut dire que dans un certain référentiel, \(\vec{p}\) est la partie spatiale d’un quadrivecteur \(\mathbf{p}\) appelé <em>quadri-impulsion</em>, ayant pour composantes:</p>

\[p^\mu = (\gamma m c, \gamma m \vec{v})\]

<p>et donc plus généralement, la quadri-impulsion s’écrit indépendamment du référentiel:</p>

\[\mathbf{p} = m\mathbf{v}\]

<p>La partie spatiale de la quadri-impulsion (\(\gamma m \vec{v}\)) correspond à la quantité de mouvement habituelle, mais quelle est donc la signification physique de sa partie temporelle \(\gamma m c\) ? Il y a plusieurs façon de le voir, mais on peut par exemple remarquer que si \(v\) est faible, on a:</p>

\[\gamma m c^2 \approx mc^2+\frac{1}{2}mv^2\]

<p>On reconnait dans la partie de droite \(\frac{1}{2}mv^2\) l’énergie cinétique du corps, due à sa vitesse, et on voit apparaître un terme constant \(mc^2\) qu’on appelle <em>énergie de masse</em>.
On peut donc poser \(E=\gamma m c^2\), \(E\) représentant l’<em>énergie</em> (totale) du corps, ce qui donne:</p>

\[p^\mu = \left(\frac{E}{c}, \gamma m \vec{v}\right) = \left(\frac{E}{c}, \vec{p}\right)\]

<p>C’est pourquoi \(\mathbf{p}\) est aussi appelé le <em>quadrivecteur énergie-impulsion</em>, car sa partie temporelle représente l’énergie du corps, et sa partie spatiale représente son impulsion (l’autre nom de la quantité de mouvement).</p>

<p>Si on calcule la pseudo-norme de \(\mathbf{p}\) dans un référentiel quelconque et dans le référentiel propre du corps, on trouve bien une valeur indépendante du référentiel:</p>

\[\eta(\mathbf{p},\mathbf{p}) = \frac{E^2}{c^2}-p^2 = m^2c^2\]

<p>avec \(p=\gamma m v = \frac{mv}{\sqrt{1-v^2/c^2}}\).</p>

<p>On obtient donc une formule fondamentale appelée relation d’Einstein: \(E^2 = m^2 c^4 + p^2 c^2\).</p>

<p>Si on se place dans le référentiel propre du corps, alors \(p=0\) et on trouve donc… \(E=mc^2\) !</p>

<p>On peut maintenant généraliser la loi fondamentale de la dynamique dans l’espace-temps, en définissant la <em>quadri-force</em> par:</p>

\[\mathbf{f} = \frac{d\mathbf{p}}{d\tau}\]

<p>Si on se place dans un certain référentiel, les coordonnées de la quadri-force sont donc:</p>

\[f^\mu = \left(\frac{1}{c}\frac{dE}{d\tau}, \frac{d\vec{p}}{d\tau}\right) = \left(\frac{\gamma}{c}\frac{dE}{dt}, \gamma\frac{d\vec{p}}{dt}\right)\]

<p>Avec un peu de calcul, on peut montrer que \(\frac{dE}{dt} = \vec{f}.\vec{v}\) (c’est la version relativiste du <em>théorème de l’énergie cinétique</em>), et donc:</p>

\[f^\mu = \left(\gamma\vec{f}.\frac{\vec{v}}{c}, \gamma\vec{f}\right)\]

<hr />

<p><em>A SUIVRE: variétés différentielles, tenseurs, fibré tangent, dérivée covariante, courbure, équation d’Einstein…</em></p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[]]></summary></entry><entry xml:lang="fr"><title type="html">Dans les coulisses de TLS (1.3): zoom sur l’algorithme X25519</title><link href="https://cdeguet.net/blog/algorithme-x25519/" rel="alternate" type="text/html" title="Dans les coulisses de TLS (1.3): zoom sur l’algorithme X25519" /><published>2021-11-24T22:00:00+01:00</published><updated>2021-11-24T22:00:00+01:00</updated><id>https://cdeguet.net/blog/algorithme-x25519</id><content type="html" xml:base="https://cdeguet.net/blog/algorithme-x25519/"><![CDATA[<p>La majorité des communications sur Internet est désormais sécurisée grâce au protocole TLS (Transport Layer Security), en particulier via le HTTPS, qui n’est rien d’autre que du HTTP encapsulé dans du TLS. En 2021, la quasi-totalité des serveurs et clients web supportent le TLS 1.2, les versions précédentes ne devant plus être utilisées car elles comportent des failles de sécurité. La version 1.3 du TLS, publiée en 2018, apporte de nombreuses améliorations et est à ce jour l’état de l’art en matière de sécurité.</p>

<p>Le rôle de TLS est d’assurer:</p>
<ul>
  <li>l’authenticité du serveur, autrement dit la garantie que le site www.mabanque.com appartient bien à Mabanque et non à la mafia nord-coréenne,</li>
  <li>la confidentialité des échanges entre le client et le serveur,</li>
  <li>l’intégrité des données, c’est-à-dire l’assurance que les données reçues par le client sont bien celles qui ont été envoyées par le serveur, et vice versa.</li>
</ul>

<p>La confidentialité repose sur le chiffrement des messages par un algorithme de chiffrement symétrique (à clé secrète), généralement de type AES 128 ou 256 bits. La clé étant secrète, elle doit être connue du client et du serveur (et personne d’autre !), ce qui nous amène au sujet de cet article: l’algorithme X25519.</p>

<p>Lorsqu’un client (par exemple un navigateur web) se connecte à un serveur TLS, il effectue d’abord ce qu’on appelle la poignée de mains (<em>handshake</em>) qui est un échange de messages servant entre autres à partager la fameuse clé secrète entre le client et le serveur. Avant TLS 1.3, divers algorithmes pouvaient être utilisés pour l’échange de clé, mais pour simplifier le protocole et améliorer la sécurité, seul l’algorithme X25519 est maintenant utilisé.</p>

<p>Cet algorithme est de la famille ECDH (<em>Elliptic-Curve Diffie-Hellman</em>), et est crucial pour la sécurité d’Internet, car toute attaque réussie sur l’algorithme impliquerait de pouvoir espionner n’importe quelle conversation chiffrée avec TLS !</p>

<p>Avant d’expliquer le fonctionnement de X25519, il faut d’abord revenir sur l’algorithme de Diffie-Hellman (DH) classique, qui était utilisé dans les vieilles versions de TLS. Le DH est assez magique car à la fois très simple et très efficace. Il repose sur le problème du “logarithme discret”, qui est relativement simple à comprendre mais difficile à résoudre.
Pour commencer, il faut choisir un nombre premier p très (très) grand, et un petit nombre g “qui convient” (je passe les détails pour l’instant), appelé le générateur. La suite de l’algorithme consiste à effectuer des calculs “modulo p”, autrement dit:</p>
<ul>
  <li>On utilise uniquement des entiers compris entre 0 et p-1</li>
  <li>Si le résultat d’un calcul sort de l’intervalle [0, p-1], on se ramène à cet intervalle en prenant le reste de la division par p</li>
</ul>

<p>Par exemple si on prend p=11, on ne travaillera qu’avec les nombres de 0 à 10, et les calculs se font comme ceci:</p>
<ul>
  <li>\(2 + 10 = 12 = 1\) (car 1 est le reste de 12 divisé par 11)</li>
  <li>\(5 * 5 = 25 = 3\) (car 3 est le reste de 25 divisé par 11)</li>
  <li>\(2 - 5 = -3 = 8\)</li>
  <li>\(3 * 4 = 12 = 1\)</li>
  <li>\(3^4 = 81 = 4\)</li>
  <li>etc.</li>
</ul>

<p>Au passage puisque 3 * 4 = 1, alors par définition 4 est l’inverse de 3 et donc 1 / 3 = 4 !</p>

<p>Ce mode de calcul s’appelle l’arithmétique dans \(\mathbb{Z}/p\mathbb{Z}\), et demande un peu de pratique mais on s’y habitue assez vite.
Pour la suite, nous aurons besoin de calculer les puissances du nombre g (modulo p). Si on prend par exemple g = 3, on obtient:</p>
<ul>
  <li>\(3^1 = 3\)</li>
  <li>\(3^2 = 9\)</li>
  <li>\(3^3 = 5\)</li>
  <li>\(3^4 = 4\)</li>
  <li>\(3^5 = 1\)</li>
  <li>\(3^6 = 3\)</li>
  <li>\(3^7 = 9\)</li>
  <li>\(3^8 = 5\)</li>
  <li>\(3^9 = 4\)</li>
  <li>\(3^{10} = 1\)</li>
</ul>

<p>On voit que dans ce cas on retombe sur le nombre g au bout de 5 itérations, et donc l’ensemble des puissances de 3 contient 5 éléments différents. En fait on peut montrer que dans le cas général, le nombre de puissances de g différentes (ce nombre est appelé “l’ordre de g” et sera noté q) est forcément un diviseur de p-1, et donc si p=11, q vaut 1, 2, 5 ou 10.</p>

<p>Ceci étant dit, l’algorithme de Diffie-Hellman est le suivant:</p>
<ul>
  <li>Alice choisit un nombre secret a et calcule \(A = g^a\). Le nombre a est appelé la clé privée d’Alice et A sa clé publique. Attention le calcul se fait toujours modulo p !</li>
  <li>De même Bob choisit un nombre b et calcule \(B = g^b\)</li>
  <li>Alice envoie à Bob sa clé publique (A), et Bob envoie à Alice sa clé publique (B)</li>
  <li>Alice calcule \(S = B^a = (g^b)^a = g^{ab}\)</li>
  <li>Bob calcule \(S’ = A^b = (g^a)^b = g^{ab}\)</li>
  <li>Comme S = S’, Alice et Bob connaissent tous les deux ce nombre et peuvent donc l’utiliser comme clé secrète.</li>
</ul>

<p>Toute la magie de l’algorithme tient au fait que l’échange des clés publiques A et B peut se faire via une communication en clair (non chiffrée), et pourtant le nombre S ne peut être connu que par Alice et Bob ! En effet même si un attaquant connaît les nombres A et B, il est lui est impossible de retrouver la clé secrète a (et donc de calculer \(B^a\)) à partir de A, car il n’existe pas de méthode efficace pour retrouver a en connaissant \(g^a\), opération appelée logarithme discret. Mais attention, il ne faut pas choisir g n’importe comment: l’ordre de g (c’est-à-dire le nombre de puissances de g différentes) doit être un nombre premier (et très grand) sinon il peut exister une attaque qui permettrait à un “homme du milieu” interceptant la communication de deviner plus (voire très) facilement la valeur de S.</p>

<p>Avec p=11 et g=3, on peut facilement fabriquer une table qui donne directement a à partir de A, mais en pratique on choisit un nombre premier de 2048 bits (!) voire plus, pour obtenir une sécurité satisfaisante. Ceci oblige à utiliser des clés très lourdes (2048 bits également) et explique que l’algorithme de DH classique est de moins en moins utilisé.</p>

<p>L’algorithme X25519 est aussi de type Diffie-Hellman, mais utilise l’arithmétique sur courbe elliptique (d’où le nom Elliptic-Curve Diffie-Hellman), beaucoup plus sophistiquée mais aussi plus efficace d’un point de vue cryptographique que le simple calcul de puissances utilisé dans le DH classique. Le nom assez mystérieux de cet algorithme sera expliqué à la fin de l’article, patience donc !</p>

<p>Pour comprendre la méthode, prenons d’abord un exemple simple: la courbe d’équation \(y^2 = x^3 + 1\) (avec x et y réels pour l’instant), qui est un exemple de courbe elliptique.
Il est possible de définir une opération d’addition sur l’ensemble des points de cette courbe, de la façon suivante: pour additionner 2 points P et Q, on trace une droite passant par P et Q et on note R le 3eme point d’intersection de cette droite avec la courbe. Alors par définition le point P+Q est le point opposé de R (noté -R), qui est le 2eme point d’intersection entre la courbe et la droite verticale passant par R:</p>

<p><img src="/blog/images/ecc-1.png" alt="Elliptic Curve Addition" width="400px" /></p>

<p>Il y a 2 cas particuliers:</p>
<ul>
  <li>Si P = Q, alors il faut prendre comme droite la tangente à la courbe au point P</li>
  <li>Si P = -Q, alors la droite passant par P et Q est verticale, et il n’y a pas de 3ème point d’intersection avec la courbe. Dans ce cas la somme P+Q est égale à un point fictif noté O, appelé le point “à l’infini” (à ne pas confondre donc avec l’origine du repère !)</li>
</ul>

<p>Avec cette définition, on peut donc choisir un point G sur la courbe, et calculer les “multiples” de ce point, c’est à dire les points:</p>
<ul>
  <li>2G = G + G</li>
  <li>3G = 2G + G</li>
  <li>4G = 3G + G</li>
  <li>etc.</li>
</ul>

<p><img src="/blog/images/ecc-2.png" alt="Elliptic Curve Mulitplication" width="400px" /></p>

<p>Mais quel rapport avec l’algorithme de Diffie-Hellman ? Et bien, grâce à la multiplication sur notre courbe elliptique, on peut appliquer exactement le même principe:</p>
<ul>
  <li>Alice choisit un nombre entier a (la clé privée), calcule le point aG, et l’envoie à Bob,</li>
  <li>Bob choisit un nombre b, calcule le point bG, et l’envoie à Alice,</li>
  <li>Alice peuvent donc chacun de leur côté calculer le point S = abG = baG, qui sera la clé secrète.</li>
</ul>

<p>Comme en pratique les ordinateurs ne peuvent pas (réellement) travailler avec des nombres réels, les “courbes” elliptiques utilisées en cryptographie ne sont pas à coordonnées réelles, mais à coordonnées entières. Plus précisément, tout comme pour l’algorithme de Diffie-Hellman classique, on travaille dans l’ensemble des entiers modulo p (\(\mathbb{Z}/p\mathbb{Z}\)), où p est un nombre premier.</p>

<p>Si on prend p=11 pour simplifier, la “courbe” d’équation \(y^2 = x^3 + 1\) contient 12 points: les 11 points bleus sur la figure suivante, ainsi que le point O (à l’infini) qui n’est pas représenté:</p>

<p><img src="/blog/images/ecc-3.png" alt="ECDH Addition" width="400px" /></p>

<p>A noter que pour représenter un point de la courbe (autre que O), il suffit de connaître la coordonnée x et de savoir si y est pair ou impair (on parle de coordonnées compressées).</p>

<p>Pour calculer la somme de 2 points de la courbe, on utilise exactement la même méthode qu’avec les nombres réels, mais avec quelques subtilités:</p>
<ul>
  <li>La “droite” passant par P et Q peut “faire le tour” du plan car on travaille modulo 11 et donc 11 est équivalent à 0 (l’espace est en fait la surface d’un tore)</li>
  <li>Pour calculer P + P, on fait comme si on travaillait avec des nombres réels pour calculer la pente de la “tangente” au point P (dans cet exemple un simple calcul de dérivée montre que la tangente a pour pente \(3x^2 / 2y\))</li>
</ul>

<p>Si on part du point G de coordonnées (2, 3), on peut ainsi calculer les points 2G, 3G, etc:</p>

<p><img src="/blog/images/ecc-4.png" alt="ECDH Multiplication" width="400px" /></p>

<p>Ici on trouve que 6G = O, et donc la boucle est bouclée (7G = G, 8G = 2G, etc.). Comme précédemment, on dit que G est d’ordre 6 car l’ensemble des multiples de G contient 6 éléments, et 6 est bien un diviseur de 12 (le nombre total de points sur la courbe).
Rappelons que pour des raisons de sécurité on cherche un point G d’ordre premier, et donc il serait préférable d’utiliser le point 2G, qui est d’ordre 3 (évidemment dans cet exemple simplifié, ça ne fait pas une grande différence; dans la vraie vie on veut que l’ordre de G soit premier et très grand).</p>

<p>Il est maintenant temps de mettre fin au suspense et de découvrir l’ensemble utilisé dans l’algorithme X25519 ! 
Cet algorithme utilise la courbe elliptique d’équation:</p>

<p>\(y^2 = x^3 + 486662 x^2 + x\) (modulo p), où \(p = 2^{255} - 19\) (d’où le nom 25519 !)</p>

<p>Le générateur utilisé est le point G de coordonnées x=9 et y impair (y est un nombre à 77 chiffres !).</p>

<p>L’ordre de G est un nombre premier légèrement supérieur à \(2^{252}\), et donne le nombre de clés privées possibles. On dit que cet algorithme offre une protection de 128 bits car une attaque en force brute nécessiterait environ \(2^{128}\) essais pour retrouver k en connaissant kG. Par comparaison, l’algorithme de Diffie-Hellman classique nécessite une clé de 3072 bits pour obtenir un niveau de sécurité équivalent.</p>

<p>A ce jour l’algorithme X25519 offre un très bon compromis entre sécurité et rapidité, et couplé avec le chiffrement symétrique AES-256-GCM, est le pilier de la sécurité d’Internet.</p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[La majorité des communications sur Internet est désormais sécurisée grâce au protocole TLS (Transport Layer Security), en particulier via le HTTPS, qui n’est rien d’autre que du HTTP encapsulé dans du TLS. En 2021, la quasi-totalité des serveurs et clients web supportent le TLS 1.2, les versions précédentes ne devant plus être utilisées car elles comportent des failles de sécurité. La version 1.3 du TLS, publiée en 2018, apporte de nombreuses améliorations et est à ce jour l’état de l’art en matière de sécurité.]]></summary></entry><entry xml:lang="fr"><title type="html">Résumé du cours de Machine Learning d’Andrew Ng</title><link href="https://cdeguet.net/blog/machine-learning/" rel="alternate" type="text/html" title="Résumé du cours de Machine Learning d’Andrew Ng" /><published>2019-11-04T11:00:00+01:00</published><updated>2019-11-04T11:00:00+01:00</updated><id>https://cdeguet.net/blog/machine-learning</id><content type="html" xml:base="https://cdeguet.net/blog/machine-learning/"><![CDATA[<p>Andrew Ng est professeur à l’université de Stanford et cofondateur de la plateforme de cours en ligne <a href="http://coursera.org">Coursera</a>. Son cours - en Anglais - sur le <em>Machine Learning</em> (ou “apprentissage automatique” en bon français) est l’un des plus anciens et populaires de Coursera, et reste une référence dans le domaine. Je vais tenter d’en résumer ici les points les plus importants.</p>

<h2 id="introduction">Introduction</h2>

<p>Qu’est-ce que le <em>Machine Learning</em> ? De façon générale c’est la capacité d’un programme informatique à apprendre à résoudre un certain type de problème, et à s’améliorer avec l’expérience. Les algorithmes de <em>Machine Learning</em> se divisent en deux catégories: l’apprentissage supervisé (<em>supervised learning</em>) et l’apprentissage non supervisé (<em>unsupervised learning</em>).</p>

<p>L’apprentissage supervisé est utilisé lorsqu’on possède un jeu de données qui à un certain nombre de variables d’entrée (<em>features</em>) associe une ou plusieurs variables de sortie. Le but de l’algorithme dans ce cas est d’apprendre à prédire les valeurs des variables de sorties si on lui donne de nouvelles variables d’entrée qui n’étaient pas dans le jeu de données initial. On peut par exemple chercher à prédire le prix d’une maison (variable de sortie) étant donné sa superficie (variable d’entrée). Si la variable de sortie est continue (comme un prix), on parle d’algorithme de <em>régression</em>. Dans d’autres problèmes, la variable de sortie est discrète, c’est-à-dire ne peut prendre qu’un certain nombre fini de valeurs, on parle alors d’algorithme de <em>classification</em>. Par exemple reconnaître si une image représente un homme ou une femme est un problème de classification. On parle d’apprentissage “supervisé” car l’algorithme doit être <em>entraîné</em> avec un jeu de données de référence, préparé à l’avance.</p>

<p>L’apprentissage non supervisé est utilisé lorsqu’on cherche à structurer automatiquement un jeu de données, par exemple en regroupant automatiquement les éléments similaires (algorithme de <em>clustering</em>), ou au contraire en séparant des éléments qui ont été mélangés (par exemple en isolant des voix au milieu d’un bruit ambiant). Dans un problème d’apprentissage non supervisé, on dispose uniquement des variables d’entrées, et on laisse l’algorithme calculer lui-même la variable de sortie, alors même qu’on ne peut pas l’entraîner avec un jeu de données de référence.</p>

<h2 id="la-régression-linéaire-simple">La régression linéaire simple</h2>

<p>La régression linéaire est la base de tous les algorithmes d’apprentissage supervisé. 
Dans sa version la plus simple, il n’y a qu’une seule variable d’entrée, notée \(x\), et une variable de sortie, notée \(y\). Si par exemple \(x\) représente la superficie d’une maison et \(y\) son prix, il nous faut un échantillon de données comportant des valeurs connues de \(x\) et \(y\), appelées <em>observations</em>:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: right">x</th>
      <th style="text-align: right">y</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: right">55</td>
      <td style="text-align: right">195000</td>
    </tr>
    <tr>
      <td style="text-align: right">110</td>
      <td style="text-align: right">305000</td>
    </tr>
    <tr>
      <td style="text-align: right">60</td>
      <td style="text-align: right">205000</td>
    </tr>
    <tr>
      <td style="text-align: right">75</td>
      <td style="text-align: right">280000</td>
    </tr>
    <tr>
      <td style="text-align: right">150</td>
      <td style="text-align: right">370000</td>
    </tr>
  </tbody>
</table>

<p>Les observations sont numérotés de 1 à \(m\). Les variables de la 2ème observation, par exemple, sont notées \(x^{(2)}\) = 110 et \(y^{(2)}\) = 305000.</p>

<p>Le but est alors de répondre à la question: quelle est l’estimation de prix la plus probable pour une maison de 100 \(m^2\) (ou n’importe quelle autre valeur de \(x\)) ?</p>

<p>Dans le modèle de régression linéaire, on cherche à prédire la valeur de \(y\) sous la forme:</p>

\[\hat{y} = h_\theta(x) = \theta_0 + \theta_1 x\]

<p>Ici le \(y\) “chapeau” désigne la valeur prédite par le modèle, à la différence du \(y\) normal qui désigne la vraie valeur de la variable. La fonction \(h_{\theta}\) s’appelle la fonction de prédiction (ou d’hypothèse), et les valeurs \(\theta_0\) et \(\theta_1\) s’appellent les paramètres du modèle. On peut également considérer que le modèle a un seul paramètre \(\theta\), qui est un vecteur de composantes \((\theta_0, \theta_1)\).</p>

<p>L’apprentissage consiste ici à déterminer quelles sont les valeurs de \(\theta_0\) et \(\theta_1\) qui donnent la meilleure estimation de \(y\). Concrètement, si on représente chaque observation par un point de coordonnées (\(x, y)\) dans un plan, il s’agit de tracer une droite qui s’approche la plus possible de toutes les observations.</p>

<h2 id="la-fonction-derreur">La fonction d’erreur</h2>

<p>Pour préciser ce que signifie une “bonne estimation” de \(y\), on définit ce qu’on appelle une fonction d’erreur (<em>cost function</em>), qui mesure l’erreur entre les valeurs prédites par le modèle et les valeurs obervées. Dans la régression linéaire, on utilise la fonction d’erreur dite des moindres carrés, qui a la forme suivante:</p>

\[J(\theta_0, \theta_1) = \frac{1}{2m}\sum_{i=1}^m\left(h_\theta(x^{(i)})-y^{(i)}\right)^2\]

<p>Cette fonction représente la sommme sur toutes les observations de la distance (au carré) entre la valeur observée de y et sa valeur prédite par le modèle. Comme le but est que l’erreur soit globalement la plus petite possible, le problème revient à minimiser la fonction d’erreur \(J\), c’est-à-dire à trouver le paramètre \(\theta\) pour lequel la valeur \(J(\theta_0, \theta_1)\) est minimale.</p>

<h2 id="lalgorithme-de-descente-du-gradient">L’algorithme de descente du gradient</h2>

<p>La méthode la plus simple pour minimiser la fonction d’erreur est l’algorithme de <em>descente du gradient</em>. Comme \(J\) est une fonction à 2 variables (\(\theta_0\) et \(\theta_1\)), on peut la représenter en 3 dimensions par une surface d’équation \(z = J(x, y)\). L’idée de la méthode de descente du gradient est que pour trouver le minimum de la fonction \(J\), c’est-à-dire le point le plus bas de la surface, il suffit de partir d’un point quelconque de cette surface et de la parcourir en prenant toujours la direction qui “descend” le plus rapidement possible, c’est-à-dire en avançant “face à la pente” de la surface (en réalité la méthode ne fonctionne à coup sûr que si la fonction n’a qu’un seul minimum local, ce qui est le cas de la fonction \(J\)). Mathématiquement, cette direction est donnée par le <em>gradient</em> de la fonction \(J\), qui est le vecteur dont les composantes sont les dérivées partielles de la fonction par rapport à chacune de ses variables:</p>

\[\nabla J(\theta_0, \theta_1) = \begin{pmatrix}\frac{\partial}{\partial \theta_0}J(\theta_0, \theta_1) \\ \frac{\partial}{\partial \theta_1}J(\theta_0, \theta_1)\end{pmatrix}\]

<p>L’algorithme consiste donc à choisir des valeurs initiales quelconques pour \(\theta_0\) et \(\theta_1\), et à ajuster ces paramètres de manière itérative en suivant la direction du gradient de \(J\). Concrètement, on applique à chaque itération la formule suivante:</p>

\[\begin{cases} \theta_0 := \theta_0 - \alpha \frac{\partial}{\partial \theta_0}J(\theta_0, \theta_1) \\ \theta_1 := \theta_1 - \alpha \frac{\partial}{\partial \theta_1}J(\theta_0, \theta_1)\end{cases}\]

<p>où \(\alpha\) est appelé le <em>taux d’apprentissage</em>. Il faut exécuter cette boucle jusqu’à la <em>convergence</em> de l’algorithme, c’est-à-dire jusqu’à ce que les paramètres \(\theta_i\) ne varient (presque) plus.</p>

<p>Dans le cas de la régression linéaire simple, la formule devient:</p>

\[\begin{cases} \theta_0 := \theta_0 - \alpha \frac{1}{m}\sum_{i=1}^m\left(h_\theta(x^{(i)})-y^{(i)}\right) \\ \theta_1 := \theta_1 - \alpha \frac{1}{m}\sum_{i=1}^m\left((h_\theta(x^{(i)})-y^{(i)})x^{(i)}\right) \end{cases}\]

<p>En examinant cette formule, on voit bien que l’on fait déjà du <em>Machine Learning</em>, et plus précisément de l’apprentissage supervisé, car le modèle apprend bien à minimiser sa fonction d’erreur grâce aux données \(x^{(i)}\) et \(y^{(i)}\) de l’échantillon de référence.</p>

<h2 id="la-régression-linéaire-multiple">La régression linéaire multiple</h2>

<p>Dans le cas général, la variable de sortie \(y\) dépend non pas d’une mais de \(n\) variables d’entrées, notées \(x_1, x_2, …, x_n\). Dans ce cas le modèle de régression linéaire devient:</p>

\[\hat{y} = h_\theta(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2 + ... + \theta_n x_n\]

<p>Pour simplifier les calculs, on va rajouter une variable d’entrée fictive \(x_0\) qui vaut toujours 1, ce qui permet de réécrire la fonction de prédiction \(h_\theta\) sous la forme:</p>

\[h_\theta(x) = \sum_{j=0}^n \theta_j x_j\]

<p>En considérant \(\theta\) et \(x\) comme des vecteurs (colonnes) de dimension n+1, on peut aussi écrire l’équation précédente sous forme matricielle:</p>

\[h_\theta(x) = \theta^T x\]

<p>Pour reprendre l’exemple de la prédiction du prix d’une maison, supposons que l’on dispose maintenant de 3 variables d’entrée \(x_1\) (superficie), \(x_2\) (nombre d’étages) et \(x_3\) (nombre de pièces), et des 5 observations suivantes:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: right">\(x_1\)</th>
      <th style="text-align: right">\(x_2\)</th>
      <th style="text-align: right">\(x_3\)</th>
      <th style="text-align: right">\(y\)</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: right">55</td>
      <td style="text-align: right">1</td>
      <td style="text-align: right">3</td>
      <td style="text-align: right">195000</td>
    </tr>
    <tr>
      <td style="text-align: right">110</td>
      <td style="text-align: right">2</td>
      <td style="text-align: right">4</td>
      <td style="text-align: right">305000</td>
    </tr>
    <tr>
      <td style="text-align: right">60</td>
      <td style="text-align: right">2</td>
      <td style="text-align: right">3</td>
      <td style="text-align: right">205000</td>
    </tr>
    <tr>
      <td style="text-align: right">75</td>
      <td style="text-align: right">1</td>
      <td style="text-align: right">4</td>
      <td style="text-align: right">280000</td>
    </tr>
    <tr>
      <td style="text-align: right">150</td>
      <td style="text-align: right">2</td>
      <td style="text-align: right">5</td>
      <td style="text-align: right">370000</td>
    </tr>
  </tbody>
</table>

<p>Les variables de la 2ème observation sont maintenant notées \(x_1^{(2)} = 110\), \(x_2^{(2)} = 2\), \(x_3^{(2)} = 4\) et \(y^{(2)} = 305000\).</p>

<p>On peut aussi représenter l’ensemble des observations par une matrice \(X\) et un vecteur \(\vec{y}\), toujours avec la convention \(x_0^{(i)} = 1\):</p>

\[X = \begin{pmatrix}1 &amp; 55 &amp; 1 &amp; 3 \\ 1 &amp; 110 &amp; 2 &amp; 4 \\ 1 &amp; 60 &amp; 2 &amp; 3 \\ 1 &amp; 75 &amp; 1 &amp; 4 \\ 1 &amp; 50 &amp; 2 &amp; 5\end{pmatrix}, \vec{y} = \begin{pmatrix}195000 \\ 305000 \\ 205000 \\ 280000 \\ 370000\end{pmatrix}\]

<p>Avec cette écriture matricielle, la fonction de prédiction devient:</p>

\[h_\theta(X) = X\theta\]

<p>La fonction d’erreur peut également s’écrire sous forme matricielle:</p>

\[\begin{align}J(\theta) &amp;= \frac{1}{2m}\sum_{i=1}^m\left(h_\theta(x^{(i)})-y^{(i)}\right)^2 \\ &amp;= \frac{1}{2m}(X\theta - \vec{y})^T(X\theta - \vec{y})\end{align}\]

<p>On peut maintenant généraliser l’algorithme de descente du gradient à \(n\) variables. A chaque itération, on applique la formule:</p>

\[\theta := \theta - \alpha \nabla J(\theta)\]

<p>ce qui donne pour chaque composante:</p>

\[\begin{align}\theta_j &amp;:= \theta_j - \alpha \frac{\partial}{\partial \theta_j}J(\theta)\\ &amp;:= \theta_j - \frac{\alpha}{m}\sum_{i=1}^m\left(h_\theta(x^{(i)})-y^{(i)}\right) x_j^{(i)} \\ &amp;:= \theta_j - \frac{\alpha}{m}\vec{x_j}^T(X\theta - \vec{y})\end{align}\]

<p>et donc sous forme matricielle:</p>

\[\boxed{\theta := \theta - \frac{\alpha}{m} X^T(X\theta - \vec{y})}\]

<h2 id="choix-des-features">Choix des <em>features</em></h2>

<p>Pour que la méthode de descente du gradient fonctionne correctement en pratique, il est recommandé de mettre à l’échelle les <em>features</em> (variables d’entrée), c’est-à-dire de faire en sorte qu’elles prennent des valeurs comprises entre -1 et 1.</p>

<p>Malgré sa simplicité, la régression linéaire multiple permet en fait de définir n’importe quel modèle, et pas seulement un modèle linéaire. Imaginons qu’on veuille estimer le prix d’une maison par un modèle polynomial comme celui-ci:</p>

\[\hat{y} = h_\theta(x) = \theta_0 + \theta_1 x_1 + \theta_2 x_2 + \theta_3 x_1 x_2 + \theta_4 x_1^2 + \theta_5 x_2^2\]

<p>Dans ce cas il suffit de définir trois nouvelles <em>features</em>: \(x_3 = x_1 x_2\), \(x_4 = x_1^2\) et \(x_5 = x_2^2\), et le problème se ramène simplement à une régression linéaire à cinq variables \(x_1, x_2, … x_5\)!</p>

<h2 id="equation-normale">Equation normale</h2>

<p>En plus de la méthode de descente du gradient, il existe aussi une méthode directe (analytique) pour minimiser la fonction d’erreur \(J(\theta)\) définie ci-dessus.</p>

<p>On peut montrer que la valeur de \(\theta\) qui minimise la fonction d’erreur est donnée par la formule suivante appelée équation normale:</p>

\[\boxed{\theta = (X^T X)^{-1} X^T \vec{y}}\]

<p>En pratique, l’équation normale n’est utilisable que si le nombre de <em>features</em> (\(n\)) n’est pas trop grand. Quand il y a plus de 10000 <em>features</em>, le calcul de la matrice \((X^T X)^{-1} X^T\) devient trop coûteux et il est nécessaire d’utiliser la méthode de descente du gradient.</p>

<p>Pour utiliser l’équation normale, il faut aussi que la matrice \(X^T X\) soit inversible, ce qui impose que les <em>features</em> soient linéairement indépendantes, et que le nombre d’observations \(m\) soit plus grand que le nombre de <em>features</em> \(n\).</p>

<h2 id="classification-et-régression-logistique">Classification et régression logistique</h2>

<p>Quand la variable à prédire n’est plus continue mais discrète, on parle d’un problème de classification. L’exemple le plus simple est la classification binaire, qui correspond au cas où \(y\) peut prendre les valeurs 0 ou 1.</p>

<p>La fonction de prédiction \(h_\theta(x)\) adaptée à la classification binaire est basée sur la fonction \(g\) suivante, qui est appelée sigmoïde ou fonction logistique:</p>

\[\begin{align}h_\theta(x) = g(\theta^T x) \\ g(z) = \frac{1}{1 + e^{-z}}\end{align}\]

<p>Concrètement, \(h_\theta(x)\) (compris entre 0 et 1) correspond à la probabilité que \(y\) prenne la valeur 1 pour une variable d’entrée donnée \(x\) (\(x\) étant ici un vecteur de \(n\) features).</p>

<p>Pour calculer le paramètre \(\theta\), on utilise la fonction d’erreur suivante:</p>

\[\begin{align}&amp; J(\theta) = \frac{1}{m}\sum_{i=1}^mC\left(h_\theta(x^{(i)}), y^{(i)}\right) \\ &amp;C(h_\theta(x), y) = -y\ ln(h_\theta(x)) - (1 - y)\ ln(1 - h_\theta(x))\end{align}\]

<p>La régression logistique consiste à trouver la valeur de \(\theta\) qui minimise cette fonction d’erreur.</p>

<p>Tout comme dans le cas de la régression linéaire, on peut utiliser la méthode de descente du gradient pour calculer \(\theta\), en appliquant la formule suivante à chaque itération:</p>

\[\boxed{\theta := \theta - \frac{\alpha}{m} X^T(g(X\theta) - \vec{y})}\]

<p>La régression logistique peut facilement se généraliser à plus de 2 classes. Il suffit de calculer pour chaque classe i une fonction de prédiction \(h_\theta^{(i)}(x)\), et pour chaque valeur de x choisir la classe i qui donne la plus grande valeur de \(h_\theta^{(i)}(x)\).</p>

<h2 id="surapprentissage-et-régularisation">Surapprentissage et régularisation</h2>

<p>Les deux problèmes classiques en <em>machine learning</em> sont le surapprentissage (<em>overfitting</em>) et le sous-apprentissage (<em>underfitting</em>).
Le sous-apprentissage signifie que le modèle donne une mauvaise estimation quelque soit l’observation (on parle de biais élevé). A l’inverse le surapprentissage signifie que le modèle donne une erreur très faible sur les données d’apprentissage, mais par contre une erreur élevée sur des nouvelles données (on parle de variance élevée). Un bon modèle doit être ni trop simple ni trop compliqué, pour éviter à la fois le sous-apprentissage et le surapprentissage.</p>

<p>Le surapprentissage peut se produire quand il y a trop de <em>features</em> par rapport au nombre d’observations. La solution est alors de simplifier le modèle en réduisant le nombre de <em>features</em>, ou bien d’appliquer la méthode de régularisation, qui consiste à diminuer les valeurs des paramètres \(\theta_j\).</p>

<p>Le principe de la régularisation est de pénaliser les valeurs trop élevées des paramètres, en rajoutant le terme \(\lambda\sum\theta_j^2\) à la fonction d’erreur. Augmenter la valeur de \(\lambda\) permet de diminuer le surapprentissage, mais si \(\lambda\) est trop élevé on risque cette fois le sous-apprentissage.</p>

<p>Pour la régression linéaire, la fonction d’erreur devient:</p>

\[J(\theta) = \frac{1}{2m}\left[ \sum_{i=1}^m\left(h_\theta(x^{(i)})-y^{(i)}\right)^2 + \lambda\sum_{j=1}^n\theta_j^2 \right]\]

<p>et l’équation normale:</p>

\[\theta = \left(X^T X+\lambda\left[ \begin{array}{cccccc}0 \\ &amp; 1 \\ &amp; &amp; 1 \\ &amp; &amp; &amp; ... \\ &amp; &amp; &amp; &amp; 1 \end{array} \right]\right)^{-1} X^T \vec{y}\]

<p>Pour la régression logistique, la fonction d’erreur devient:</p>

\[\begin{align}&amp; J(\theta) = \frac{1}{m}\sum_{i=1}^mC\left(h_\theta(x^{(i)}), y^{(i)}\right) + \frac{\lambda}{2m}\sum_{j=1}^n\theta_j^2\\ &amp;C(h_\theta(x), y) = -y\ ln(h_\theta(x)) - (1 - y)\ ln(1 - h_\theta(x))\end{align}\]

<p><em>A suivre…</em></p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[Andrew Ng est professeur à l’université de Stanford et cofondateur de la plateforme de cours en ligne Coursera. Son cours - en Anglais - sur le Machine Learning (ou “apprentissage automatique” en bon français) est l’un des plus anciens et populaires de Coursera, et reste une référence dans le domaine. Je vais tenter d’en résumer ici les points les plus importants.]]></summary></entry><entry xml:lang="fr"><title type="html">Installer un cluster Kubernetes sous Debian 9</title><link href="https://cdeguet.net/blog/kubernetes-debian-vps/" rel="alternate" type="text/html" title="Installer un cluster Kubernetes sous Debian 9" /><published>2018-02-12T11:00:00+01:00</published><updated>2018-02-12T11:00:00+01:00</updated><id>https://cdeguet.net/blog/kubernetes-debian-vps</id><content type="html" xml:base="https://cdeguet.net/blog/kubernetes-debian-vps/"><![CDATA[<p>En quelques années, <a href="https://kubernetes.io">Kubernetes</a> est devenu un incontournable pour l’orchestration de <em>containers</em> sous Linux, mais reste assez complexe à prendre en main.
Le but de cet article est de montrer comment installer facilement son propre cluster Kubernetes sur une ferme de serveurs sous Debian 9 (<em>stretch</em>), grâce à <em>kubeadm</em> et <em>flannel</em>.</p>

<h2 id="prérequis">Prérequis</h2>

<p>Pour ce tutorial, j’ai installé un cluster Kubernetes (version 1.9.3) sur 2 machines virtuelles chez OVH, de type <a href="https://www.ovh.com/fr/vps/vps-ssd.xml">VPS SSD 1</a>, c’est-à-dire l’entrée de gamme avec 1 vCore, 2 GB de RAM et 10 GB de disque SSD.</p>

<p>Chaque VM tourne sous Debian 9 (stretch), sans aucune dépendance particulière installée. La procédure devrait fonctionner à l’identique sur des serveurs physiques, ou n’importe quel type de VM.</p>

<p>Le but est de configurer un noeud Kubernetes de type <em>master</em> (sur la VM <code class="language-plaintext highlighter-rouge">vps01</code>) et un noeud de type <em>worker</em> (sur la VM <code class="language-plaintext highlighter-rouge">vps02</code>), mais on peut très facilement rajouter autant de <em>workers</em> que nécessaire.</p>

<h2 id="installation-de-doker">Installation de Doker</h2>

<p>Sur les 2 machines, installer d’abord Docker en suivant la documentation officielle (commandes à lancer en <em>root</em>):</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code># apt-get install -y apt-transport-https ca-certificates curl gnupg2 software-properties-common
# curl -fsSL https://download.docker.com/linux/$(. /etc/os-release; echo "$ID")/gpg | # apt-key add -
# add-apt-repository "deb [arch=amd64] https://download.docker.com/linux/debian stretch stable"
# apt-get update
# apt-get install -y docker-ce
</code></pre></div></div>

<h2 id="installation-de-kubernetes">Installation de Kubernetes</h2>

<p>Ensuite, il faut installer <em>kubeadm</em> sur chaque VM:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code># curl -s https://packages.cloud.google.com/apt/doc/apt-key.gpg | apt-key add -
# add-apt-repository "deb http://apt.kubernetes.io/ kubernetes-xenial main"
# apt-get update
# apt-get install -y kubelet kubeadm kubectl
</code></pre></div></div>

<p>Puis sur la machine <code class="language-plaintext highlighter-rouge">vps01</code>, lancer <code class="language-plaintext highlighter-rouge">kubeadm init</code> pour initialiser le <em>master</em>, en choisissant l’adresse du réseau à utiliser pour les pods:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code># kubeadm init --pod-network-cidr=10.244.0.0/16
</code></pre></div></div>

<p>Si tout se passe bien, vous devriez voir le message suivant:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>You can now join any number of machines by running the following on each node
as root:

    kubeadm join --token 184...
</code></pre></div></div>

<p><strong>Notez</strong> cette commande <code class="language-plaintext highlighter-rouge">kubadm join ...</code>, qui servira plus tard à ajouter les noeuds <em>worker</em> au cluster.</p>

<p>Pour pouvoir utiliser <code class="language-plaintext highlighter-rouge">kubectl</code>, copiez la configuration Kubernetes dans le HOME de votre compte utilisateur (pas <em>root</em>):</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ mkdir -p $HOME/.kube
debian@vps001:~$ sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
debian@vps001:~$ sudo chown $(id -u):$(id -g) $HOME/.kube/config
</code></pre></div></div>

<p>Pour finir la configuration du cluster, il faut installer un plugin pour configurer le réseau virtual utilisé par les pods.
J’ai utilisé <a href="https://github.com/coreos/flannel"><em>flannel</em></a>, que l’on peut déployer comme ceci:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl apply -f https://github.com/coreos/flannel/raw/master/Documentation/kube-flannel.yml
</code></pre></div></div>

<p>Si tout s’est bien passé, le cluster devrait être opérationnel en quelques minutes maximum:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl get pods --all-namespaces
NAMESPACE     NAME                                READY     STATUS    RESTARTS   AGE
kube-system   etcd-vps001                         1/1       Running   0          18m
kube-system   kube-apiserver-vps001               1/1       Running   0          18m
kube-system   kube-controller-manager-vps001      1/1       Running   0          18m
kube-system   kube-dns-6a4cd2bdf-df76v            3/3       Running   0          19m
kube-system   kube-flannel-ds-zrsw9               1/1       Running   0          1m
kube-system   kube-proxy-mhkh2                    1/1       Running   0          19m
kube-system   kube-scheduler-vps001               1/1       Running   0          18m
</code></pre></div></div>

<p>A ce stade, il suffit de lancer la commande <code class="language-plaintext highlighter-rouge">kubeadm join --token ...</code> notée précédemment sur les autres machines, pour ajouter les noeuds <em>worker</em> au cluster.</p>

<h2 id="installation-du-dashboard-kubernetes">Installation du dashboard Kubernetes</h2>

<p>Pour installer le <em>dashboard</em>:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl apply -f https://raw.githubusercontent.com/kubernetes/dashboard/master/src/deploy/recommended/kubernetes-dashboard.yaml
</code></pre></div></div>

<p>Puis créer un utilisateur <em>admin-user</em>:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ cat admin-user.yaml
apiVersion: v1
kind: ServiceAccount
metadata:
  name: admin-user
  namespace: kube-system

debian@vps001:~$ kubectl create -f admin-user.yaml

debian@vps001:~$ cat admin-role.yaml
apiVersion: rbac.authorization.k8s.io/v1beta1
kind: ClusterRoleBinding
metadata:
  name: admin-user
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: cluster-admin
subjects:
- kind: ServiceAccount
  name: admin-user
  namespace: kube-system

debian@vps001:~$ kubectl apply -f admin-role.yaml
</code></pre></div></div>

<p>Pour vous connecter au dashboard, vous aurez besoin d’un <em>token</em>, que l’on peut afficher comme ceci:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl -n kube-system describe secret $(kubectl -n kube-system get secret | grep admin-user | awk '{print $1}')
Name:         admin-user-token-vqsw4
...
Data
====
ca.crt:     1025 bytes
namespace:  11 bytes
token:      eyJhbGciOiJSUzI1NiIsInR5cCI6....
</code></pre></div></div>

<p>Par défaut, le dashboard n’est pas accessible depuis l’extérieur, mais il est possible de s’y connecter en lançant un <em>proxy</em> dans un terminal:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl proxy
</code></pre></div></div>

<p>Le proxy écoute sur 127.0.0.1:8001, donc vous pouvez par exemple créer un tunnel SSH pour vous y connecter depuis votre propre ordinateur:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>$ ssh -L 8001:127.0.0.1:8001 debian@vps001
</code></pre></div></div>

<p>Et le dashboard est accessible à l’URL <a href="http://localhost:8001/api/v1/namespaces/kube-system/services/https:kubernetes-dashboard:/proxy/">http://localhost:8001/api/v1/namespaces/kube-system/services/https:kubernetes-dashboard:/proxy/</a></p>

<p>Recopiez ensuite le token récupéré précédemment pour vous connecter. Et voilà !</p>

<h2 id="configurer-le-noeud-master-comme-un-worker">Configurer le noeud master comme un worker</h2>

<p>Par défaut Kubernetes ne lance pas de pod (autres que les pods système) sur le noeud master.</p>

<p>Il est possible de désactiver cette restriction avec la commande suivante:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl taint nodes vps001 node-role.kubernetes.io/master-
</code></pre></div></div>

<p>Pour revenir au comportement par défaut:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ kubectl taint nodes vps001 node-role.kubernetes.io/master=:NoSchedule
</code></pre></div></div>

<h2 id="configurer-le-monitoring-avec-heapster">Configurer le monitoring avec Heapster</h2>

<p><a href="https://github.com/kubernetes/heapster.git">Heapster</a> fournit un monitoring complet de votre cluster Kubernetes, grâce à InfluxDB et Grafana.</p>

<p>Pour installer Heapster:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>debian@vps001:~$ git clone https://github.com/kubernetes/heapster.git
debian@vps001:~$ kubectl apply -f heapster/deploy/kube-config/influxdb/
debian@vps001:~$ kubectl apply -f heapster/deploy/kube-config/rbac/heapster-rbac.yaml
</code></pre></div></div>

<p>Et le dashboard est accessible à travers le proxy avec l’URL suivante: <a href="http://127.0.0.1:8001/api/v1/namespaces/kube-system/services/monitoring-grafana/proxy/">http://127.0.0.1:8001/api/v1/namespaces/kube-system/services/monitoring-grafana/proxy/</a></p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[En quelques années, Kubernetes est devenu un incontournable pour l’orchestration de containers sous Linux, mais reste assez complexe à prendre en main. Le but de cet article est de montrer comment installer facilement son propre cluster Kubernetes sur une ferme de serveurs sous Debian 9 (stretch), grâce à kubeadm et flannel.]]></summary></entry><entry xml:lang="fr"><title type="html">Déployer un site Jekyll sur Amazon CloudFront</title><link href="https://cdeguet.net/blog/deployer-jekyll-aws/" rel="alternate" type="text/html" title="Déployer un site Jekyll sur Amazon CloudFront" /><published>2018-02-03T14:54:34+01:00</published><updated>2018-02-03T14:54:34+01:00</updated><id>https://cdeguet.net/blog/deployer-jekyll-aws</id><content type="html" xml:base="https://cdeguet.net/blog/deployer-jekyll-aws/"><![CDATA[<p>Dans cet article, je vais expliquer pourquoi et comment déployer un site Web statique généré avec Jekyll (par exemple un blog) dans le <em>cloud</em>, avec Amazon S3 et CloudFront.</p>

<h2 id="de-quoi-sagit-t-il-exactement">De quoi s’agit-t-il exactement?</h2>

<p>Commençons par <a href="https://jekyllrb.com/">Jekyll</a>: il s’agit de générateur de site Web à partir de fichiers sources au format <a href="https://en.wikipedia.org/wiki/Markdown">Markdown</a>. Je ne vais pas rentrer dans les détails de Jekyll ici, donc si vous ne connaissez pas, allez d’abord voir la documentation ;-)</p>

<p>Un site construit avec Jekyll contient uniquement des fichiers statiques: HTML, images, CSS, et éventuellement JavaScript. Pour déployer un tel site en production, il n’y a donc pas besoin de serveur PHP ni de base de données (comme c’est le cas pour un site WordPress): un simple serveur Web (comme Apache ou nginx) suffit.</p>

<p>En fait grâce au <em>cloud</em>, il est même possible de se passer complètement du serveur Web: tous les fichiers du site peuvent être stockés sur Amazon S3 et publiés avec Amazon CloudFront. Amazon S3 (<em>Simple Storage Service</em>) est ce que l’on appelle un <em>Object Store</em>: il permet de stocker en vrac des fichiers de toute taille, et d’y accéder par exemple en HTTP(s) depuis Internet. Amazon CloudFront est un CDN (<em>Content Delivery Network</em>), c’est-à-dire un énorme cache distribué dans le monde entier, qui permet de diffuser efficacement des ressources Web (images, vidéos, fichiers JavaScript, etc.) en les répliquant sur des serveurs proches des utilisateurs.</p>

<p>L’intérêt principal de CloudFront, et d’un CDN en général, est d’améliorer la vitesse et la disponibilité du site. En effet, sans le CDN, toutes les requêtes HTTP sont envoyées sur le(s) serveur(s) Amazon S3 d’une certaine <em>région</em> (celle où vous avez choisi de stocker les fichiers), qui est potentiellement très éloignée des utilisateurs qui accèdent au site, ce qui entraîne une certaine latence réseau. Avec le CDN, les requêtes seront traitées par un serveur plus proche, ce qui diminue la latence si le fichier demandé est déjà mis en cache.</p>

<h2 id="publication-du-site-sur-amazon-s3">Publication du site sur Amazon S3</h2>

<p>Pour cette étape, il faut d’abord souscrire à un abonnement sur <a href="https://aws.amazon.com">AWS</a> (<em>Amazon Web Services</em>), en profitant éventuellement de l’offre d’essai gratuite.</p>

<p>Ensuite, dans la console AWS, il faut choisir le service S3 (dans la catégorie Stockage), et créer un nouveau “compartiment” (<em>bucket</em>), en lui donnant par exemple le nom du site à déployer (disons <code class="language-plaintext highlighter-rouge">blog.monsite.com</code>).</p>

<p>Dans les propriétés du compartiment, activer l’option “Hébergement de site Web statique”, noter quelque part l’URL du “Point de terminaison” et mettre <code class="language-plaintext highlighter-rouge">index.html</code> comme Document d’index. Pour autoriser l’accès public au site, il faut créer une “Stratégie de compartiment” (<em>bucket policy</em>) dans l’onglet “Autorisations”, et copier le contenu suivant:</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
    </span><span class="nl">"Statement"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="w">
        </span><span class="p">{</span><span class="w">
            </span><span class="nl">"Sid"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Acces en lecture"</span><span class="p">,</span><span class="w">
            </span><span class="nl">"Effect"</span><span class="p">:</span><span class="w"> </span><span class="s2">"Allow"</span><span class="p">,</span><span class="w">
            </span><span class="nl">"Principal"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
                </span><span class="nl">"AWS"</span><span class="p">:</span><span class="w"> </span><span class="s2">"*"</span><span class="w">
            </span><span class="p">},</span><span class="w">
            </span><span class="nl">"Action"</span><span class="p">:</span><span class="w"> </span><span class="s2">"s3:GetObject"</span><span class="p">,</span><span class="w">
            </span><span class="nl">"Resource"</span><span class="p">:</span><span class="w"> </span><span class="s2">"arn:aws:s3:::blog.monsite.com/*"</span><span class="w">
        </span><span class="p">}</span><span class="w">
    </span><span class="p">]</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>en mettant le nom du compartiment dans le champ “Resource”.</p>

<p>Une fois le compartiment créé, il ne reste plus qu’à générer et copier les fichiers du site. On peut le faire depuis l’interface Web, ou bien avec le client <code class="language-plaintext highlighter-rouge">aws</code> en ligne de commande, par exemple comme ceci sous Linux ou macOS:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>JEKYLL_ENV=production bundler exec jekyll build --destination ~/blog --incremental
aws s3 sync ~/blog s3://blog.monsite.com
</code></pre></div></div>

<p>Maintenant pour tester que tout fonctionne, essayez d’ouvrir l’URL notée précédemment (qui devrait ressembler à quelque chose comme <code class="language-plaintext highlighter-rouge">http://blog.monsite.com.s3-website.eu-west-3.amazonaws.com</code>), et normalement le site devrait apparaître !</p>

<h2 id="configuration-de-cloudfront">Configuration de CloudFront</h2>

<p>Pour l’instant, le site est déjà accessible sur Internet depuis Amazon S3, mais l’objectif était que tout le trafic passe par le CDN d’Amazon, autrement dit CloudFront.</p>

<p>Avant de configurer CloudFront, il faut d’abord créer un certificat SSL/TLS pour votre nom de domaine, pour pouvoir accéder au site en HTTPS. Cherchez “Certificate Manager” dans la console AWS, et suivez les instructions.</p>

<p>Une fois le certificat SSL/TLS crée, il faut retourner dans la console AWS, ouvrir le service “CloudFront”, et choisir “Créer une distribution”. A l’étape 1, choisir “distribution Web”, puis à l’étape 2, remplir les champs suivants:</p>

<ul>
  <li>
    <p><strong>Nom du domaine d’origine</strong>: mettre le domaine du site créé sur Amazon S3, dans notre cas <code class="language-plaintext highlighter-rouge">blog.monsite.com.s3-website.eu-west-3.amazonaws.com</code>. Attention! Il ne faut pas choisir <code class="language-plaintext highlighter-rouge">blog.monsite.com.s3.amazonaws.com</code>, sinon le site ne fonctionnera pas correctement (les URLs des sous-répertoires du site ne s’afficheront pas)</p>
  </li>
  <li>
    <p><strong>Stratégie de protocole d’utilisateur</strong>: choisir l’option “Rediriger HTTP vers HTTPS”</p>
  </li>
  <li>
    <p><strong>Autres noms de domaines (CNAME)</strong>: mettre votre nom de domaine (<code class="language-plaintext highlighter-rouge">blog.monsite.com</code>)</p>
  </li>
  <li>
    <p><strong>Cerfificat SSL personnalisé</strong>: choisir le certificat SSL/TSL créé précédemment</p>
  </li>
</ul>

<p>Enfin, cliquer sur “Créer une distribution” pour finaliser la création.</p>

<p>Maintenant vous pouvez accéder à votre site avec le nom de domaine CloudFront indiqué dans la console, par exemple <code class="language-plaintext highlighter-rouge">https://d115ozry1ec5gl.cloudfront.net</code>.</p>

<p>La dernière étape est de déclarer votre nom de domaine comme un alias (CNAME) du domaine CloudFront. La procédure exacte dépend de votre fournisseur de DNS, mais dans tous les cas l’enregistrement DNS devrait ressembler à quelque chose comme:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>blog.monsite.com.   IN  CNAME d115ozry1ec5gl.cloudfront.net.
</code></pre></div></div>

<p>(attention à ne pas oublier le <code class="language-plaintext highlighter-rouge">.</code> à la fin du CNAME !)</p>

<p>Et voilà, si vous avez suivi toutes les étapes, vous devriez avoir un site <code class="language-plaintext highlighter-rouge">https://blog.monsite.com</code> rapide comme l’éclair, servi par Amazon CloudFront !</p>

<h2 id="contrôle-du-cache">Contrôle du cache</h2>

<p>Malheureusement, les ennuis vont commencer dès que vous voudrez faire une mise à jour de votre site.</p>

<p>En effet, si vous essayez de modifier la page d’accueil et de la republier sur Amazon S3, il y a de fortes chances que les modifications n’apparaissent tout simplement pas, même en forçant un raffraîchissement de la page dans le navigateur !</p>

<p>Pour éviter ce problème, il faut éditer les propriétés du fichier <code class="language-plaintext highlighter-rouge">index.html</code> dans la console S3, et ajouter la métadonnée <code class="language-plaintext highlighter-rouge">Cache-Control</code> avec la valeur <code class="language-plaintext highlighter-rouge">no-cache</code>, ce qui indiquera à CloudFront (et au navigateur) qu’il faut toujours envoyer une requête au serveur d’origine (S3 dans ce cas) pour vérifier si le fichier n’a pas été modifié depuis la mise en cache.</p>

<p>Si le mal est déjà fait, il est possible d’<em>invalider</em> manuellement un fichier mis en cache dans CloudFront, en choisissant “Créer une invalidation” dans l’onglet “Invalidations” de la console CloudFront.</p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[Dans cet article, je vais expliquer pourquoi et comment déployer un site Web statique généré avec Jekyll (par exemple un blog) dans le cloud, avec Amazon S3 et CloudFront.]]></summary></entry><entry xml:lang="fr"><title type="html">Beancount ou la comptabilité pour les hackers</title><link href="https://cdeguet.net/blog/beancount-comptabilite-pour-hackers/" rel="alternate" type="text/html" title="Beancount ou la comptabilité pour les hackers" /><published>2015-09-03T13:22:46+02:00</published><updated>2015-09-03T13:22:46+02:00</updated><id>https://cdeguet.net/blog/beancount-comptabilite-pour-hackers</id><content type="html" xml:base="https://cdeguet.net/blog/beancount-comptabilite-pour-hackers/"><![CDATA[<p>En matière de comptabilité personnelle, l’offre en logiciels et autres applications pour smartphones ne manque pas, et pourtant après de nombreuses tentatives je n’ai rien trouvé qui me convenait: les solutions existantes étaient toujours ou trop simplistes ou trop complexes, trop chères, pas assez ergonomiques, trop instables, et j’en passe…</p>

<p>Sur le point de développer ma propre application, j’ai finalement découvert <a href="http://furius.ca/beancount"><em>Beancount</em></a>, qui s’approche de la perfection, en tout cas pour mes besoins. Je vais donc présenter dans cet article le principe de Beancount, et comment l’utiliser pour gérer ses comptes.</p>

<p>Beancount est basé sur la comptabilité <em>en partie double</em>, et repose sur l’enregistrement des transactions dans un simple fichier texte: il est donc possible de tout faire en ligne de commande, ce qui ravira les fans de Linux, et fera certainement fuir les autres utilisateurs habitués aux interfaces graphiques ;) . Beancount fournit entre autres une interface Web pour explorer ses comptes, un langage de requêtes similaire à SQL,  et permet d’écrire ses propres plugins et scripts en Python pour étendre les fonctionnalités.</p>

<h2 id="la-comptabilité-en-partie-double">La comptabilité en partie double</h2>
<p>Avant de comprendre Beancount, il faut d’abord maîtriser les bases de la <em>comptabilité en partie double</em>. Il s’agit de la méthode utilisée pour effectuer la comptabilité d’une entreprise, d’une organisation, ou d’un État dans les règles de l’art, mais on peut très bien l’appliquer pour gérer ses comptes personnels.</p>

<p>Son principe est assez simple: toute transaction (achat, vente, virement, etc.) est représentée par un <em>transfert</em> d’argent entre deux (ou plus) <em>comptes</em>. La notion de compte est ici à prendre au sens large: il peut s’agir d’un compte bancaire, d’un compte de caisse, mais aussi d’un poste de dépenses, d’un compte représentant des stocks, etc.</p>

<p>La règle absolue à respecter dans la comptabilité en partie double est que tout <em>sortie</em> d’argent doit être compensée par une <em>rentrée</em> équivalente (et vice-versa). Par exemple, supposons que vous achetez un lot de ramettes de papier pour 50 euros: votre compte bancaire sera donc diminué de 50 euros, et en contrepartie il faut augmenter votre compte “Fournitures de bureau” de 50 euros. De même, si vous recevez un salaire de 2000 euros, vous augmentez votre compte bancaire de 2000 euros, et en contrepartie vous devez donc diminuer votre compte “Salaires” du même montant.</p>

<p>A ce stade, voici comment on peut enregistrer ces opérations en comptabilité:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Date</th>
      <th style="text-align: left">Compte</th>
      <th style="text-align: left">Libellé</th>
      <th style="text-align: right">Montant</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">2015-05-12</td>
      <td style="text-align: left">Banque</td>
      <td style="text-align: left">Achat papier</td>
      <td style="text-align: right">-50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-12</td>
      <td style="text-align: left">Fournitures de bureau</td>
      <td style="text-align: left">Achat papier</td>
      <td style="text-align: right">+50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-30</td>
      <td style="text-align: left">Banque</td>
      <td style="text-align: left">Salaire mai 2015</td>
      <td style="text-align: right">+2000 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-30</td>
      <td style="text-align: left">Salaire</td>
      <td style="text-align: left">Salaire mai 2015</td>
      <td style="text-align: right">-2000 EUR</td>
    </tr>
  </tbody>
</table>

<p>Grâce au principe de partie double, c’est-à-dire l’écriture de toute transaction dans deux comptes simultanément, la somme de toutes les opérations est toujours nulle, ce qui permet de s’assurer facilement qu’il n’y a pas d’erreur dans les comptes.</p>

<p>Il peut sembler peu intuitif que le compte “Salaire” soit négatif, puisque c’est de l’argent gagné, mais il suffit de se souvenir que les comptes doivent s’équilibrer, donc si le compte “Banque” augmente, le compte “Salaire” doit diminuer. Une autre façon de voir les choses est de considérer l’argent du salaire comme la contepartie d’un travail: le salarié <em>reçoit</em> de l’argent sur son compte en banque en échange du travail qu’il <em>donne</em> à son employeur. Puisque le travail est donné, c’est donc quelque chose qui “sort”, et par conséquent il doit être comptabilisé en négatif.</p>

<p>Après avoir enregistré toutes les opérations, on peut calculer le <strong>solde</strong> de chaque compte, en additionant tous les montants affectés à ces comptes depuis leur ouverture:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Compte</th>
      <th style="text-align: right">Solde</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Banque</td>
      <td style="text-align: right">+1950 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">Fournitures de Bureau</td>
      <td style="text-align: right">+50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">Salaire</td>
      <td style="text-align: right">-2000 EUR</td>
    </tr>
  </tbody>
</table>

<p>Si vous avez compris les explications précédentes, il doit être clair que la somme des soldes de tous les comptes doit être égale à 0, ce qui est une bonne façon de vérifier qu’il n’y a pas d’erreurs.</p>

<p><img src="/blog/images/Pacioli.jpg" alt="Pacioli" width="300px" /></p>

<h2 id="actif-passif-dépenses-et-recettes">Actif, Passif, Dépenses et Recettes</h2>
<p>Pour organiser la comptabilité, les différents comptes sont répartis en quatre catégories: <em>actif</em>, <em>passif</em>, <em>recettes</em> et <em>dépenses</em>, qu’on peut définir ainsi:</p>

<ul>
  <li><strong>Actif</strong>: l’argent qu’on possède</li>
  <li><strong>Passif</strong>: l’argent qu’on doit</li>
  <li><strong>Dépenses (ou Charges)</strong>: l’argent qui sort</li>
  <li><strong>Recettes</strong> <strong>(ou Produits)</strong>: l’argent qui rentre</li>
</ul>

<p>Si on reprend l’exemple précédent, on voit facilement que:</p>

<ul>
  <li>Le compte “Banque” est un compte d’<em>actif</em></li>
  <li>Le compte “Fournitures de bureau” est un compte de <em>dépenses</em></li>
  <li>Le compte “Salaire” est un compte de <em>recettes</em></li>
</ul>

<p>Les comptes de passif sont utilisés par exemple lorsqu’on achète un bien à crédit. Supposons que vous achetez vos ramettes de papier le 12 mai, et que vous payez le fournisseur (METRO par exemple) une semaine plus tard. Dans ce cas, il y a deux transactions à enregistrer dans la comptabilité:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Date</th>
      <th style="text-align: left">Compte</th>
      <th style="text-align: left">Libellé</th>
      <th style="text-align: right">Montant</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">2015-05-12</td>
      <td style="text-align: left">Magasin METRO</td>
      <td style="text-align: left">Achat papier facture 123456</td>
      <td style="text-align: right">-50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-12</td>
      <td style="text-align: left">Fournitures de bureau</td>
      <td style="text-align: left">Achat papier facture 123456</td>
      <td style="text-align: right">+50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-19</td>
      <td style="text-align: left">Banque</td>
      <td style="text-align: left">Paiement facture METRO 123456</td>
      <td style="text-align: right">-50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-19</td>
      <td style="text-align: left">Magasin METRO</td>
      <td style="text-align: left">Paiement facture METRO 123456</td>
      <td style="text-align: right">+50 EUR</td>
    </tr>
  </tbody>
</table>

<p>Le compte “Magasin METRO” (compte de fournisseur) est ici un compte de <em>passif</em>, car il correspond à une dette.</p>

<p>Si on fait la somme des opérations, on voit que le tout revient à transférer 50 euros du compte “Banque” vers le compte “Fournitures de bureau”, car les opérations sur le compte “Magasin METRO” s’annulent une fois que la facture a été payée. Un des intérêts de la comptabilité en partie double est qu’elle permet de comptabiliser correctement ce genre de dettes, même si elles ne sont que temporaires. Dans le cas d’un crédit immobilier, la dette peut durer de nombreuses années donc il est encore plus important d’en garder une trace !</p>

<p>Pour être tout à fait complet, il faut préciser que le passif se compose en réalité de deux parties: les <strong>Dettes</strong> et le <strong>Capital</strong>. Dans la comptabilité anglo-saxonne, le capital est une catégorie de compte à part entière, alors que dans la comptabilité française, dettes et capital sont regroupés sous le même terme de “passif”. La notion de capital n’est pas forcément intuitive, disons pour faire simple que dans le cas d’une entreprise, le capital représente la valeur de cette entreprise, c’est-à-dire l’actif moins les dettes. Dit autrement, le capital représente la <em>dette</em> de l’entreprise vis-à-vis de ses propres actionnaires (ou associés), c’est d’ailleurs pourquoi il est classé parmi les comptes de passif.</p>

<p>En pratique, il suffit de se souvenir que <strong>l’actif doit toujours être égal au passif</strong>, car tout ce qu’une société possède est une dette envers quelqu’un d’autre (envers les créanciers ou les associés). Le capital peut donc être considéré comme une “astuce” technique pour équilibrer les comptes: si l’actif est supérieur aux dettes (ce que je vous souhaite), la différence entre les deux se retrouve automatiquement au capital.</p>

<p>Pour finir, il est utile de remarquer que les comptes d’actif et de passif permettent d’évaluer l’état des finances d’une entreprise <em>à n’importe quel instant</em>, et sont appelés <strong>comptes de bilan</strong>. D’un autre côté, les comptes de recettes et de dépenses traduisent les mouvements financiers de l’entreprise <em>sur une période donnée</em>, et sont appelés <strong>comptes de gestion</strong>. Dans une entreprise, les comptes de gestion sont remis à zéro (soldés) chaque année lors de la clôture des comptes, et au passage le solde restant (appelé <strong>résultat</strong> de l’exercice comptable, ou également <strong>bénéfice</strong> lorsqu’il est positif) est transféré sur un compte de capital.</p>

<h2 id="débit-et-crédit">Débit et crédit</h2>
<p>L’approche que j’ai décrite jusqu’ici (et qui est celle utilisée dans <em>Beancount</em>) pourra sembler surprenante à ceux qui ont déjà des notions de comptabilité.</p>

<p>En réalité, les comptables ne représentent pas les transferts entre comptes par des montants positifs ou négatifs, mais utilisent les notions (peu intuitives au premier abord) de <em>débit</em> et <em>crédit</em>:</p>

<ul>
  <li>Un <strong>débit</strong> représente une <strong>entrée</strong> vers un compte</li>
  <li>Un <strong>crédit</strong> représente une <strong>sortie</strong> depuis un compte</li>
</ul>

<p>Dans une écriture comptable, on note les débits et crédits dans deux colonnes différentes, le débit étant toujours à <em>gauche</em>, et le crédit à <em>droite</em>, et on utilise seulement des nombres positifs.</p>

<p>Si on reprend notre exemple initial, les transactions s’écrivent dans un comptabilité traditionnelle sous la forme suivante:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Date</th>
      <th style="text-align: left">Compte</th>
      <th style="text-align: left">Libellé</th>
      <th style="text-align: right">Débit</th>
      <th style="text-align: right">Crédit</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">2015-05-12</td>
      <td style="text-align: left">Banque</td>
      <td style="text-align: left">Achat papier</td>
      <td style="text-align: right"> </td>
      <td style="text-align: right">50 EUR</td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-12</td>
      <td style="text-align: left">Fournitures de bureau</td>
      <td style="text-align: left">Achat papier</td>
      <td style="text-align: right">50 EUR</td>
      <td style="text-align: right"> </td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-30</td>
      <td style="text-align: left">Banque</td>
      <td style="text-align: left">Salaire mai 2015</td>
      <td style="text-align: right">2000 EUR</td>
      <td style="text-align: right"> </td>
    </tr>
    <tr>
      <td style="text-align: left">2015-05-30</td>
      <td style="text-align: left">Salaire</td>
      <td style="text-align: left">Salaire mai 2015</td>
      <td style="text-align: right"> </td>
      <td style="text-align: right">2000 EUR</td>
    </tr>
  </tbody>
</table>

<p>Le principe est le même que précédemment, mais au lieu d’utiliser des montants positifs pour les entrées d’argent, on écrit les montants dans la colonne “débit”, et au lieu d’utiliser des montants négatifs pour les sorties, on écrit les montants dans la colonne “crédit”, toujours en utilisant des nombres positifs.</p>

<p>Avec cette méthode, le calcul du solde des comptes est plus compliqué, puisqu’il faut manipuler des débits et des crédits au lieu de faire une simple addition. Si la somme des débits est supérieure à la somme des crédits, le solde du compte est <em>débiteur</em>, et si la somme des crédits est supérieure à la somme des débits, le solde du compte est <em>créditeur</em>.</p>

<p>Avec notre exemple, on obtient:</p>

<table>
  <thead>
    <tr>
      <th style="text-align: left">Compte</th>
      <th style="text-align: right">Total débits</th>
      <th style="text-align: right">Total crédits</th>
      <th>Solde débiteur</th>
      <th style="text-align: right">Solde créditeur</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td style="text-align: left">Banque</td>
      <td style="text-align: right">1950 EUR</td>
      <td style="text-align: right"> </td>
      <td>1950 EUR</td>
      <td style="text-align: right"> </td>
    </tr>
    <tr>
      <td style="text-align: left">Fournitures de Bureau</td>
      <td style="text-align: right">50 EUR</td>
      <td style="text-align: right"> </td>
      <td>50 EUR</td>
      <td style="text-align: right"> </td>
    </tr>
    <tr>
      <td style="text-align: left">Salaire</td>
      <td style="text-align: right"> </td>
      <td style="text-align: right">2000 EUR</td>
      <td> </td>
      <td style="text-align: right">2000 EUR</td>
    </tr>
  </tbody>
</table>

<p>Tout serait bien plus simple en se limitant à l’utilisation des nombres positifs et négatifs, comme le fait Beancount, mais des siècles d’histoire de la comptabilité en ont décidé autrement (en réalité, la séparation des opérations en débits et crédits a bien une utilité en pratique, par exemple pour détecter les erreurs de saisie et les fraudes).</p>

<p>Pour ajouter à la confusion, cette terminologie débit / crédit est exactement l’inverse de ce que vous pouvez trouver chaque mois sur votre relevé bancaire, puisqu’un compte en banque est toujours censé être <em>créditeur</em> et non débiteur ! En fait le paradoxe s’explique facilement: du point de vue de votre banque, l’argent disponible sur votre compte est de l’argent qu’elle vous doit, c’est donc un <em>crédit</em> pour elle. Par contre de votre point de vue, la situation est exactement l’inverse et cet argent est donc compté comme un <em>débit</em>.</p>

<p>À noter que les comptes d’actif et de dépenses sont en principe toujours débiteurs (donc “positifs”), et les comptes de passif et de recettes sont en principe toujours créditeurs (donc “négatifs”).</p>

<h2 id="plan-de-comptes">Plan de comptes</h2>
<p>Le dernier point à aborder est la notion de <strong>plan de comptes</strong>. C’est tout simplement la liste de tous les comptes utilisés pour effectuer la comptabilité.</p>

<p>En France, il est obligatoire de suivre une réglementation appelée <a href="https://fr.wikipedia.org/wiki/Plan_comptable_g%C3%A9n%C3%A9ral_%28France%29">Plan Comptable Général</a> (PCG) pour faire la comptabilité d’une entreprise. Le PCG définit un plan de compte standard, qui classe les différents comptes en 7 catégories principales, et attribue un numéro à chaque type de compte. Le compte “Fournitures consommables” porte par exemple le numéro 6022, et il contient (entre autres) un sous-compte “Fournitures de bureau” qui porte le numéro 60225.</p>

<p>Pour une comptabilité personnelle, il est inutile de suivre les recommendations du PCG, mais il faut tout de même réfléchir à la liste des comptes qu’on doit utiliser, et à la manière des les classer.</p>

<p>Dans Beancount, chaque compte doit être affecté à une des 5 catégories suivantes:</p>

<ul>
  <li><strong>Assets</strong> (Actif)</li>
  <li><strong>Liabilities</strong> (Passif)</li>
  <li><strong>Equity</strong> (Capital)</li>
  <li><strong>Income</strong> (Recettes)</li>
  <li><strong>Expenses</strong> (Dépenses)</li>
</ul>

<p>Comme expliqué précédemment, le Capital est une catégorie à part dans le système anglo-saxon, qui est utilisé par Beancount.</p>

<p>Par défaut ces noms sont en anglais dans Beancount, mais il est possible de définir une option pour les renommer en français (ou en n’importe quoi).</p>

<p>Un plan de compte utilisable dans Beancount pourrait ressembler à ceci:</p>

<ul>
  <li>Actif:LCL:CompteCheques</li>
  <li>Actif:LCL:LivretA</li>
  <li>Passif:LCL:CreditImmobilier</li>
  <li>Recettes:Salaire</li>
  <li>Recettes:Loyer</li>
  <li>Depenses:Charges:RemboursementCredit</li>
  <li>Depenses:Charges:Electricite</li>
  <li>Depenses:Charges:Telephone</li>
  <li>Depenses:Charges:Imports</li>
  <li>Depenses:Alimentation</li>
  <li>Depenses:Loisirs</li>
  <li>Depenses:Sante</li>
  <li>Depenses:Vetements</li>
  <li>Depenses:Transports</li>
  <li>Depenses:Transports:Voiture</li>
  <li>Depenses:Logement</li>
  <li>Depenses:Autres</li>
</ul>

<p>L’utilisation du séparateur “:” permet de définir une hiérarchie de comptes, par exemple “Depenses:Transport:Voiture” est un sous-compte du compte “Depenses:Transport”. Ce n’est pas obligatoire, mais permet de mieux s’y retrouver quand on utilise un grand nombre de comptes (l’exemple précédent est très simplifié; j’utilise personnellement une centaine de comptes différents).</p>

<p>Une petite limitation de Beancount est qu’il n’est pas possible d’utiliser des espaces dans un nom de compte, il faut donc utiliser des tirets à la place, ou coller les mots comme je l’ai fait dans l’exemple.</p>

<h2 id="fonctionnement-général-de-beancount">Fonctionnement général de Beancount</h2>
<p>Grâce à ces notions de base de comptabilité, il est maintenant possible de rentrer dans le vif du sujet, à savoir le fonctionnement de Beancount.</p>

<p>Contrairement à la majorité des logiciels de comptabilité, Beancount se lance en ligne de commande, et n’a donc pas <em>besoin</em> d’interface graphique. Son auteur, Martin Blais, s’est inspiré de <a href="http://www.ledger-cli.org/">Ledger</a>, qui fonctionne sur le même principe.</p>

<p>L’idée principale est d’utiliser un <strong>langage</strong> spécifique (un <em>Domain Specific Language</em> ou DSL, en anglais) pour décrire ses transactions dans un simple fichier texte. Une fois que ce fichier est écrit (avec n’importe quel éditeur de texte), Beancount fournit différents outils pour en tirer divers rapports et statistiques, <em>sans jamais modifier le fichier original</em>. Il est également possible d’accéder à certains rapports avec une interface Web, qui est très pratique pour naviguer dans les comptes, mais ne permet pas de toute façon de modifier le fichier de comptes.</p>

<p>Le format utilisé pour décrire les transactions a été conçu pour être facilement manipulable à la fois par un humain ou par un programme, contrairement à la quasi-totalité des autres formats existants.</p>

<p>Il est temps de passer à la pratique ! En langage Beancount, notre exemple d’achat de papier s’écrit comme ceci:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2015-05-12 * "Achat papier"
  Actif:Banque                    -50.00 EUR
  Depenses:FournituresDeBureau     50.00 EUR
</code></pre></div></div>

<p>Le format est extrêmement simple: chaque transaction commence par une ligne avec la date et une description, puis en dessous on écrit les opérations pour les différents comptes impactés par la transaction. On remarque qu’il n’est pas question ici de débits et crédits: la notation utilise des montants positifs et négatifs comme expliqué dans l’introduction.</p>

<p>Étant donné que la somme des écritures d’une même transaction doit toujours être nulle, il est possible de laisser Beancount calculer automatiquement le montant d’une des écritures, ce qui donne la forme simplifiée suivante:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2015-05-12 * "Achat papier"
  Actif:Banque                    -50.00 EUR
  Depenses:FournituresDeBureau
</code></pre></div></div>

<p>En fait avant d’enregistrer des transactions, il faut d’abord <em>ouvrir</em> les comptes utilisés, grâce à la directive “open”. Par exemple on ouvre le compte “Banque” comme ceci:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2000-01-01 open Actif:Banque EUR
</code></pre></div></div>

<p>L’ordre des écritures dans le fichier n’a pas d’importance, par contre les dates doivent être cohérentes, il faut donc évidemment que le compte soit ouvert avant d’apparaître dans une transaction.</p>

<p>Voici maintenant un exemple complet de fichier Beancount, qu’on appelera par exemple “compta.beancount”:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>; Options pour renommer les catégories de base
option "name_assets" "Actif"
option "name_liabilities" "Passif"
option "name_equity" "Capital"
option "name_income" "Recettes"
option "name_expenses" "Depenses"
option "account_previous_balances" "SoldeOuverture"
option "account_previous_earnings" "Benefice:Precedents"
option "account_current_earnings" "Benefice:Courant"

; Ouverture des comptes
2000-01-01 open Actif:Banque EUR
2000-01-01 open Passif:MagasinMETRO EUR
2000-01-01 open Capital:SoldeOuverture EUR
2000-01-01 open Recettes:Salaire EUR
2000-01-01 open Depenses:FournituresDeBureau EUR

; Complète automatiquement le solde d'ouverture
2000-01-01 pad Actif:Banque Capital:SoldeOuverture

; Dernier solde connu
2015-05-31 balance Actif:Banque  2640.00 EUR

; Journal des écritures 

2015-05-12 * "Achat papier facture 123456"
  Passif:MagasinMETRO             -50.00 EUR
  Depenses:FournituresDeBureau

2015-05-19 * "Paiement facture METRO 123456"
  Actif:Banque                    -50.00 EUR
  Passif:MagasinMETRO

2015-05-30 * "Salaire mai 2015"
  Actif:Banque                   2000.00 EUR
  Recettes:Salaire
</code></pre></div></div>

<p>Les options ne sont pas nécessaires si vous souhaitez garder les noms par défaut en anglais.</p>

<p>Cet exemple montre également une fonctionnalité extrêmement pratique de Beancount, qui est le remplissage automatique des “trous” dans la comptabilité, grâce aux directive “pad” et “balance”:</p>

<ul>
  <li>“balance” permet d’indiquer le solde connu d’un compte à une certaine date</li>
  <li>“pad” permet d’insérer automatiquement une écriture pour que le solde du compte soit respecté</li>
</ul>

<p>Dans cet exemple, la directive “pad” est équivalente à la transaction suivante:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2000-01-01 * "Remplissage automatique"
  Actif:Banque                   690.00 EUR
  Capital:SoldeOuverture        -690.00 EUR
</code></pre></div></div>

<p>Le solde initial du compte est donc calculé automatiquement, alors qu’on ne connaissait que le solde final.</p>

<p>Au passage on remarque que le solde initial du compte “Banque” est pris depuis le compte “Capital:SoldeOuverture”, qui est dédié à ce genre d’opérations. En effet l’argent doit toujours venir de quelque part, et ce compte représente le capital que l’on possédait avant de démarrer sa comptabilité sous Beancount.</p>

<p>Voilà, maintenant que nous avons un fichier Beancount, il faut bien faire quelque chose avec ! Pour commencer, nous pouvons utiliser la commande “bean-report” pour produire différents rapports, par exemple le solde courant de chaque compte, ce qu’on appelle la <em>balance des comptes</em>:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt; bean-report compta.beancount balances
Actif:Banque                     2,640.00 EUR
Capital:SoldeOuverture            -690.00 EUR
Depenses:FournituresDeBureau        50.00 EUR
Passif:MagasinMETRO          
Recettes:Salaire                -2,000.00 EUR
</code></pre></div></div>

<p>On peut aussi par exemple afficher le <em>journal</em> (l’ensemble des écritures) d’un compte donné, comme ceci:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt; bean-report compta.beancount journal -a Passif:MagasinMETRO
2000-01-01 open  Passif:MagasinMETRO
2015-05-12 *     Achat papier facture 123456                     -50.00 EUR
2015-05-19 *     Paiement facture METRO 123456                    50.00 EUR
</code></pre></div></div>

<p>La façon la plus simple d’explorer ses comptes reste encore l’interface Web, qui se lance avec la commande “bean-web”:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt; bean-web compta.beancount
</code></pre></div></div>
<p>Par défaut, l’interface est accessible à l’adresse http://127.0.0.1:8080/. Elle permet de visualiser le journal, le bilan, la balance des comptes, et le compte de résultat, éventuellement par année.</p>

<p>Voici par exemple le bilan (<em>balance sheet</em> en anglais) de notre exemple pour l’année 2015, c’est-à-dire le tableau récapitulant le solde de tous les comptes d’actif et passif:</p>

<p><img src="/blog/images/beancount-bilan.png" alt="Bilan" width="862px" /></p>

<h2 id="importation-automatique-des-transactions">Importation automatique des transactions</h2>
<p>Bien sûr il n’est pas très pratique de rentrer à la main toutes les transactions, surtout en l’absence d’interface graphique pour faciliter la tâche.</p>

<p>La solution la plus pratique consiste à <em>exporter</em> ses comptes depuis le site de sa banque (au format CSV, Quicken, OFX, ou autre) et de convertir les fichiers automatiquement au format Beancount, par exemple grâce à l’outil <a href="https://bitbucket.org/blais/ledgerhub">LedgerHub</a> (du même auteur).</p>

<p>Il est toujours possible de rectifier le fichier obtenu après coup, par exemple pour ajouter des remarques ou éliminer des doublons.</p>

<h2 id="requêtes-personnalisées-avec-bean-query">Requêtes personnalisées avec <em>bean-query</em></h2>
<p>Si on veut obtenir des rapports plus précis, il est possible d’utiliser l’outil “bean-query”, qui fournit un langage de requêtes similaire à SQL:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>&gt; bean-query compta.beancount
Input file: "Beancount"
Ready with 11 directives (8 postings in 4 transactions).
beancount&gt;
</code></pre></div></div>

<p>Si on veut par exemple retrouver toutes les transactions dont la description contient le texte “123456” (un numéro de facture en l’occurence) pendant l’année 2015, on peut lancer la requête suivante:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>beancount&gt; SELECT date, account, narration, change WHERE narration ~ "123456" AND year = 2015
   date              account                      narration             change  
---------- ---------------------------- ----------------------------- ----------
2015-05-12 Passif:MagasinMETRO          Achat papier facture 123456   -50.00 EUR
2015-05-12 Depenses:FournituresDeBureau Achat papier facture 123456    50.00 EUR
2015-05-19 Actif:Banque                 Paiement facture METRO 123456 -50.00 EUR
2015-05-19 Passif:MagasinMETRO          Paiement facture METRO 123456  50.00 EUR
</code></pre></div></div>

<p>On peut aussi regrouper les résultats par compte, en affichant uniquement la somme des écritures pour chaque compte:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>beancount&gt; SELECT account, SUM(change) WHERE narration ~ "123456" AND year = 2015 GROUP by account
          account            sum_change
---------------------------- ----------
Depenses:FournituresDeBureau  50.00 EUR
Actif:Banque                 -50.00 EUR
Passif:MagasinMETRO
</code></pre></div></div>

<p>Avec cet exemple, on vérifie ainsi que le compte “Passif:MagasinMETRO” a un solde nul, ce qui signifie que la facture a bien été payée.</p>

<p>Les possibilités sont sans fin, il ne reste plus qu’à faire preuve d’imagination !</p>

<h2 id="scripts-et-plugins-en-python">Scripts et plugins en Python</h2>
<p>Pour finir, voyons comment écrire ses propres programmes en utilisant l’API Python de Beancount.</p>

<p>Rien ne vaut un exemple, donc voici un petit programme Python qui ouvre un fichier Beancount, et affiche la date et la description de toutes les transactions:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">#!/usr/bin/env python3
</span>
<span class="kn">from</span> <span class="nn">beancount</span> <span class="kn">import</span> <span class="n">loader</span>
<span class="kn">from</span> <span class="nn">beancount.core.data</span> <span class="kn">import</span> <span class="n">Transaction</span>

<span class="n">PATH</span> <span class="o">=</span> <span class="s">"compta.beancount"</span>
<span class="n">entries</span><span class="p">,</span> <span class="n">errors</span><span class="p">,</span> <span class="n">options</span> <span class="o">=</span> <span class="n">loader</span><span class="p">.</span><span class="n">load_file</span><span class="p">(</span><span class="n">PATH</span><span class="p">)</span>
<span class="k">for</span> <span class="n">entry</span> <span class="ow">in</span> <span class="n">entries</span><span class="p">:</span>
    <span class="k">if</span> <span class="nb">isinstance</span><span class="p">(</span><span class="n">entry</span><span class="p">,</span> <span class="n">Transaction</span><span class="p">):</span>
        <span class="k">print</span><span class="p">(</span><span class="n">entry</span><span class="p">.</span><span class="n">date</span><span class="p">,</span> <span class="n">entry</span><span class="p">.</span><span class="n">narration</span><span class="p">)</span>
</code></pre></div></div>

<p>L’exécution du programme produit le résultat suivant:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>2000-01-01 (Padding inserted for Balance of 2640.00 EUR for difference 690.00 EUR)
2015-05-12 Achat papier facture 123456
2015-05-19 Paiement facture METRO 123456
2015-05-30 Salaire mai 2015
</code></pre></div></div>

<p>Et voilà ! J’espère vous avoir donné un bon aperçu des possibilités de Beancount, et pour plus de détails il vous reste à lire la documentation sur <a href="http://furius.ca/beancount/">le site du projet</a> !</p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[En matière de comptabilité personnelle, l’offre en logiciels et autres applications pour smartphones ne manque pas, et pourtant après de nombreuses tentatives je n’ai rien trouvé qui me convenait: les solutions existantes étaient toujours ou trop simplistes ou trop complexes, trop chères, pas assez ergonomiques, trop instables, et j’en passe…]]></summary></entry><entry xml:lang="fr"><title type="html">Introduction à Docker</title><link href="https://cdeguet.net/blog/introduction-docker/" rel="alternate" type="text/html" title="Introduction à Docker" /><published>2015-08-25T13:15:15+02:00</published><updated>2015-08-25T13:15:15+02:00</updated><id>https://cdeguet.net/blog/introduction-docker</id><content type="html" xml:base="https://cdeguet.net/blog/introduction-docker/"><![CDATA[<p>Depuis son lancement en 2013, <a href="https://www.docker.com/">Docker</a> est un projet qui fait beaucoup parler de lui, et pour de bonnes raisons !</p>

<p><img src="/blog/images/docker.png" alt="Docker" width="291px" /></p>

<h2 id="ceci-est-une-révolution">Ceci est une révolution</h2>

<p>En très très bref, Docker est un outil permettant de déployer facilement des applications sur un serveur Linux.</p>

<p>En un peu moins bref, Docker fournit un moyen d’encapsuler des applications dans des <em>containers </em>isolés, et de démarrer ces containers sur n’importe quel machine Linux, quelle que soit la distribution installée. En ce sens, Docker couvre les mêmes besoins qu’une <em>machine virtuelle</em> (VM), mais comme nous allons le voir, il y a tout de même des différences importantes entre containers et VMs.</p>

<p>Alors où est la révolution dans tout ça ? Après tout, n’importe quelle distribution Linux permet d’installer une nouvelle application en quelques clics, ou avec une simple ligne de commande. Mais que se passe-t-il si l’application qu’on souhaite installer n’est pas disponible dans la distribution, ou si seulement une vieille version est disponible ? Il faut alors récupérer un <em>package</em> par ses propres moyens, et c’est généralement là que les ennuis commencent:</p>

<ul>
  <li>Le package peut avoir des dépendances incompatibles avec les autres packages déjà installés, et c’est l’impasse…</li>
  <li>Pire, il se peut qu’aucun package ne soit disponible, il faut alors télécharger le code source et passer des heures à essayer de compiler l’application soi-même (avec un fort risque de retomber sur les problèmes de dépendances)</li>
  <li>En supposant que l’application démarre, elle n’a jamais été testée et validée sur sa propre machine, et donc des nouveaux bugs peuvent apparaitre. Même avec de la bonne volonté, l’auteur de l’application peut avoir beaucoup de mal à reproduire (et donc à corriger) le problème puisque son environnement de travail est différent.</li>
</ul>

<h2 id="containers-et-union-mount">Containers et <em>union mount</em></h2>

<p>Avec Docker, chaque application est exécutée à l’intérieur d’un container, qui contient <em>l’ensemble</em> des dépendances requises par cette application. Chaque container Docker possède son propre système de fichier, qui embarque l’intégralité d’une distribution Linux (par exemple une Ubuntu), avec les packages nécessaires pour faire tourner l’application. Il n’y a donc plus aucun problème de dépendances, car l’environnement d’exécution est complètement maitrisé et déterministe.</p>

<p>Mais alors si on souhaite lancer plusieurs dizaines (ou centaines) d’applications sur une même machine, l’espace disque ne risque-t-il pas d’exploser, avec toutes ces distributions Linux installées en même temps ? En fait non ! Docker utilise une astuce appelée <em>union mount</em>, qui consiste à découper un système de fichiers en plusieurs couches (<em>layers</em>), et à pouvoir partager ces couches entre plusieurs systèmes de fichiers. En pratique, tous les containers basés sur la même distribution Linux vont en fait partager les mêmes fichiers de base (les bibliothèques et binaires système, les fichiers de configuration, etc.), et seule la <em>différence</em> entre ces containers est stockée sur disque. C’est une des grandes différences entre container Docker et VM: il est littéralement possible de lancer des <em>milliers</em> de containers sur la même machine, tout en utilisant très peu d’espace disque si ces containers sont similaires.</p>

<p><img src="/blog/images/wm298811tt.jpg" alt="Sandwich" width="400px" /></p>

<p>Un autre aspect fondamental du fonctionnement de Docker est qu’un container n’est rien de plus qu’un <em>process</em> Linux (en réalité, un arbre de process) isolé. La conséquence est que <em>démarrer</em> un container revient en fait simplement à <em>exécuter</em> un process, ce qui est pratiquement aussi rapide que lancer ce même process en dehors d’un container. Au contraire d’une VM qui doit lancer un système d’exploitation complet au démarrage, ce qui peut prendre plusieurs dizaines de secondes, le démarrage d’un container Docker est donc quasiment instantané (tout dépend de l’application, évidemment) !</p>

<p>Docker fournit donc un moyen beaucoup plus léger qu’une VM pour encapsuler une application, mais les innovations ne s’arrêtent pas là !</p>

<h2 id="imagesrepositories-et-registry">Images, repositories et registry</h2>

<p>Une grande idée de Docker est d’avoir repris les mêmes concepts que les systèmes de gestion de versions modernes, comme <a href="https://git-scm.com/"><em>Git</em></a>. Le principe est qu’un container Docker est toujours créé à partir d’une <em>image</em> Docker, qui est en quelque sorte un modèle (<em>template</em>) de container. Ces images sont conservées, et versionnées, dans un dépôt (<em>repository)</em> stocké en local sur la machine. Il est donc possible à tout instant de recréer un container Docker à partir d’une image d’une version précédente, de passer facilement d’une version à l’autre, ou même d’exécuter simultanément des containers basés sur des versions différentes.</p>

<p>Là où Docker rejoint encore Git, c’est qu’il est possible d’envoyer des images Docker sur un repository distant, appelé <em>registry</em>, ce qui permet facilement de partager et échanger des images entre plusieurs personnes. De même que <a href="https://github.com/">Github</a> permet de publier son code source sous Git sur Internet, Docker fournit le <a href="https://hub.docker.com/">Docker Hub</a>, qui est un registry public contenant des milliers d’images Docker prêtent à l’emploi. Il est par exemple possible de télécharger l’image officielle de <em>Wordpress</em> sur le Docker Hub, ce qui permet de lancer Worpdress (avec serveur Web et PHP déjà intégrés) sur sa machine en quelques secondes !</p>

<p>Encore plus fort: le concept de <em>Dockerfile</em> définit un standard simple pour créer une image Docker soi-même. Un Dockerfile n’est rien d’autre qu’un fichier texte, contenant quelques commandes à exécuter pour construire une image Docker à partir d’une autre image (généralement venant du Docker Hub).</p>

<p>Voici par exemple un Dockerfile minimaliste permettant de créer une image Docker Ubuntu contenant un serveur MySQL:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>FROM ubuntu:14.04
ENV DEBIAN_FRONTEND=noninteractive
RUN apt-get update &amp;amp;&amp;amp; apt-get -yq install mysql-server
EXPOSE 3306
CMD ["/usr/bin/mysqld_safe"]
</code></pre></div></div>

<h2 id="du-container-au-navire">Du container au navire</h2>
<p>Le nom de “Docker” vient de l’analogie entre les containers Linux et le transport de marchandises. Grâces aux <em>conteneurs</em> (ceux de la vraie vie, cette fois), il est possible de transporter n’importe quelle marchandise sur n’importe quel bateau, train ou camion, n’importe où dans le monde. Comment ce miracle de la logistique est-il possible ? Tout simplement parce que les conteneurs ont des dimensions standard, ce qui permet de les transporter toujours de la même façon, quel que soit leur contenu. Ainsi, le fournisseur n’a pas à se soucier du mode de transport de ses marchandises, il lui suffit de tout mettre dans un conteneur, et le transporteur fera le reste. De la même façon, le transporteur n’a pas besoin de savoir ce que contiennent les conteneurs pour les transporter, du moment que le standard est respecté.</p>

<p><img src="/blog/images/asia2009-kmtc-jakarta-3635116-o.jpg" alt="Cargo" width="320px" /></p>

<p>Il se passe exactement la même chose avec les containers Docker, sauf qu’ici, le fournisseur est le développeur de l’application, et le transporteur est l’hébergeur. Il suffit au développeur d’encapsuler son application dans un container Docker, sans se soucier de la plateforme technique de l’hébergeur, et l’application peut être ainsi déployée de la même façon sur la propre machine du développeur, dans un data center privé, dans un cloud public, etc. De son côté, l’hébergeur peut manipuler des applications “enfermées” dans des containers Docker sans se soucier de leur contenu: différentes applications développées en Java, PHP, Python, Go, Node.js pourront donc être déployées et opérées exactement de la même façon sur un même serveur.</p>]]></content><author><name></name></author><category term="fr" /><category term="docker" /><category term="linux" /><summary type="html"><![CDATA[Depuis son lancement en 2013, Docker est un projet qui fait beaucoup parler de lui, et pour de bonnes raisons !]]></summary></entry><entry xml:lang="fr"><title type="html">11 raisons d’aimer le C++11</title><link href="https://cdeguet.net/blog/11-raisons-d-aimer-c++11/" rel="alternate" type="text/html" title="11 raisons d’aimer le C++11" /><published>2015-06-24T00:00:00+02:00</published><updated>2015-06-24T00:00:00+02:00</updated><id>https://cdeguet.net/blog/11-raisons-d-aimer-c++11</id><content type="html" xml:base="https://cdeguet.net/blog/11-raisons-d-aimer-c++11/"><![CDATA[<p>Le C++ a fait beaucoup de chemin depuis les années 1980, et beaucoup d’améliorations significatives ont été apportées au langage avec le standard C++11, sorti en 2011.</p>

<p>En tant que développeur C++, vous allez très certainement apprécier les 11 nouvelles fonctionalités présentées ci-dessous (mais il y en a bien d’autres !).</p>

<h2 id="1-le-type-auto">1) Le type “auto”</h2>

<p>Fatigué des déclarations de variables à rallonge telles que <code class="language-plaintext highlighter-rouge">std::map&lt;std::string, std::pair&lt;int, int&gt; &gt;::const_iterator iter;</code> ?</p>

<p>Le C++11 a introduit le type <em>auto</em>, qui devine automatiquement le type d’une variable en fonction du contexte.  Appréciez:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">map</span><span class="o">&lt;</span><span class="n">std</span><span class="o">::</span><span class="n">string</span><span class="p">,</span> <span class="n">std</span><span class="o">::</span><span class="n">pair</span><span class="o">&lt;</span><span class="kt">int</span><span class="p">,</span> <span class="kt">int</span><span class="o">&gt;</span> <span class="o">&gt;</span> <span class="n">myMap</span><span class="p">;</span>
<span class="p">...</span>
<span class="k">auto</span> <span class="n">iter</span> <span class="o">=</span> <span class="n">myMap</span><span class="p">.</span><span class="n">find</span><span class="p">(</span><span class="mi">42</span><span class="p">);</span>
</code></pre></div></div>

<h2 id="2-les-boucles-for-sur-intervalle">2) Les boucles “for” sur intervalle</h2>

<p>Tous les languages modernes supportent les boucles de types “foreach”, qui permettent d’itérer facilement sur une collection quelconque. C’est maintenant également le cas pour le C++:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">list</span><span class="o">&lt;</span><span class="n">std</span><span class="o">::</span><span class="n">string</span><span class="o">&gt;</span> <span class="n">myList</span><span class="p">;</span>
<span class="p">...</span>
<span class="k">for</span> <span class="p">(</span><span class="k">auto</span> <span class="n">item</span><span class="o">:</span> <span class="n">myList</span><span class="p">)</span>
<span class="p">{</span>
    <span class="n">std</span><span class="o">::</span><span class="n">cout</span> <span class="o">&lt;&lt;</span> <span class="n">item</span> <span class="o">&lt;&lt;</span> <span class="n">std</span><span class="o">::</span><span class="n">endl</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<h2 id="3-les-listes-dinitialisation-étendues">3) Les listes d’initialisation étendues</h2>

<p>Les conteneurs STL standards peuvent maintenant être initialisés facilement avec des accolades (ce qui était auparavant possible uniquement avec des objets de type POD):</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="kt">int</span><span class="o">&gt;</span> <span class="n">myVector</span> <span class="o">=</span> <span class="p">{</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">7</span><span class="p">};</span>
</code></pre></div></div>

<p>ou même:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="kt">int</span><span class="o">&gt;</span> <span class="n">myVector</span> <span class="p">{</span><span class="mi">1</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">7</span><span class="p">};</span>
</code></pre></div></div>

<h2 id="4-initialisation-uniforme">4) Initialisation uniforme</h2>

<p>En C++11, les accolades peuvent êtres utilisées de la même façon pour initialiser n’importe quoi, que ce soit un conteneur STL, un objet, un tableau, un tableau d’objets, etc.</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">struct</span> <span class="nc">Foo</span> 
<span class="p">{</span>
    <span class="n">Foo</span><span class="p">(</span><span class="kt">int</span> <span class="n">n</span><span class="p">,</span> <span class="n">std</span><span class="o">::</span><span class="n">string</span> <span class="n">s</span><span class="p">)</span><span class="o">:</span> <span class="n">m_n</span><span class="p">(</span><span class="n">n</span><span class="p">),</span> <span class="n">m_s</span><span class="p">(</span><span class="n">s</span><span class="p">)</span> <span class="p">{}</span>
    <span class="kt">int</span> <span class="n">m_n</span><span class="p">;</span>
    <span class="n">std</span><span class="o">::</span><span class="n">string</span> <span class="n">m_s</span><span class="p">;</span>
<span class="p">};</span>

<span class="n">Foo</span> <span class="n">myObject</span> <span class="p">{</span><span class="mi">12</span><span class="p">,</span> <span class="s">"foo"</span><span class="p">};</span>
<span class="n">Foo</span> <span class="n">myArray</span><span class="p">[]</span> <span class="p">{{</span><span class="mi">12</span><span class="p">,</span> <span class="s">"foo"</span><span class="p">},</span> <span class="p">{</span><span class="mi">42</span><span class="p">,</span> <span class="s">"bar"</span><span class="p">}};</span>
<span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="n">Foo</span><span class="o">&gt;</span> <span class="n">myVector</span> <span class="p">{{</span><span class="mi">12</span><span class="p">,</span> <span class="s">"foo"</span><span class="p">},</span> <span class="p">{</span><span class="mi">42</span><span class="p">,</span> <span class="s">"bar"</span><span class="p">}};</span>
</code></pre></div></div>

<p>Quand le type de l’objet peut être deviné par le compilateur, par exemple pour la valeur de retour d’une fonction, il n’est même pas nécessaire de spécifier le type lors de l’initialisation !</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">pair</span><span class="o">&lt;</span><span class="kt">int</span><span class="p">,</span> <span class="n">std</span><span class="o">::</span><span class="n">string</span><span class="o">&gt;</span> <span class="n">foo</span><span class="p">()</span>
<span class="p">{</span>
    <span class="k">return</span> <span class="p">{</span><span class="mi">12</span><span class="p">,</span> <span class="s">"foo"</span><span class="p">};</span>
<span class="p">}</span>

<span class="k">auto</span> <span class="n">myPair</span> <span class="o">=</span> <span class="n">foo</span><span class="p">();</span>
</code></pre></div></div>

<h2 id="5-expressions-lambda-et-closures">5) Expressions lambda et <em>closures</em></h2>

<p>Une expression lambda est simplement une fonction anonyme, qui peut-être définie à n’importe quel endroit du code s’attendant à recevoir un pointeur de fonction.</p>

<p>Les expressions lambda sont très utiles pour la programmation fonctionnelle, pour éviter de définir des fonctions très petites qui ne sont appelées qu’une seule fois.</p>

<p>Par exemple, pour incrémenter tous les éléments d’un vecteur, on peut écrire:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="kt">int</span><span class="o">&gt;</span> <span class="n">myVec</span> <span class="p">{</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">};</span>
<span class="n">std</span><span class="o">::</span><span class="n">for_each</span><span class="p">(</span><span class="n">myVec</span><span class="p">.</span><span class="n">begin</span><span class="p">(),</span> <span class="n">myVec</span><span class="p">.</span><span class="n">end</span><span class="p">(),</span> <span class="p">[](</span><span class="kt">int</span> <span class="o">&amp;</span><span class="n">n</span><span class="p">)</span> <span class="p">{</span><span class="n">n</span><span class="o">++</span><span class="p">;});</span>
</code></pre></div></div>
<p>Ici, <code class="language-plaintext highlighter-rouge">[]</code> est l’équivalent de <code class="language-plaintext highlighter-rouge">lambda</code> en Python ou <code class="language-plaintext highlighter-rouge">function</code> en Javascript.</p>

<p>Pourquoi cette syntaxe étrange <code class="language-plaintext highlighter-rouge">[]</code> ? Parce qu’il est en fait possible de mettre quelque chose à l’intérieur des crochets, pour créer une <em>closure</em>.</p>

<p>Une <em>closure</em> est une expression lambda qui <em>capture</em> une ou plusieurs variables locales définies en dehors de sa portée. En Python et en Javascript, toutes les variables locales définies dans la même portée qu’une expression lambda sont capturées implicitement, mais comme les développeurs C++ aiment tout contrôler (sinon ils ne développeraient pas en C++!), la liste des variables à capturer dans une <em>closure</em> C++11 doit être specifiée explicitement à l’intérieur des crochets.</p>

<p>Par exemple, si on veut incrémenter tous les éléments de notre vecteur d’un certain nombre <code class="language-plaintext highlighter-rouge">delta</code>, on peut écrire:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="kt">int</span><span class="o">&gt;</span> <span class="n">myVec</span> <span class="p">{</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">};</span>
<span class="kt">int</span> <span class="n">delta</span> <span class="o">=</span> <span class="mi">4</span><span class="p">;</span>
<span class="n">std</span><span class="o">::</span><span class="n">for_each</span><span class="p">(</span><span class="n">myVec</span><span class="p">.</span><span class="n">begin</span><span class="p">(),</span> <span class="n">myVec</span><span class="p">.</span><span class="n">end</span><span class="p">(),</span> <span class="p">[</span><span class="n">delta</span><span class="p">](</span><span class="kt">int</span> <span class="o">&amp;</span><span class="n">n</span><span class="p">)</span> <span class="p">{</span><span class="n">n</span> <span class="o">+=</span> <span class="n">delta</span><span class="p">;});</span>
</code></pre></div></div>
<p>Remarquez que si la variable <code class="language-plaintext highlighter-rouge">delta</code> n’est pas spécifiée dans la liste de capture, le compilateur produit une erreur.</p>

<p>Par défaut, les variables sont capturées par valeur, mais elles peuvent aussi être capturées par référence. Par exemple, on peut calculer la somme des éléments d’un vecteur en utilisant une <em>closure</em> comme ceci:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="kt">int</span><span class="o">&gt;</span> <span class="n">myVec</span> <span class="p">{</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">};</span>
<span class="kt">int</span> <span class="n">sum</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span>
<span class="n">std</span><span class="o">::</span><span class="n">for_each</span><span class="p">(</span><span class="n">myVec</span><span class="p">.</span><span class="n">begin</span><span class="p">(),</span> <span class="n">myVec</span><span class="p">.</span><span class="n">end</span><span class="p">(),</span> <span class="p">[</span><span class="o">&amp;</span><span class="n">sum</span><span class="p">](</span><span class="kt">int</span> <span class="o">&amp;</span><span class="n">n</span><span class="p">)</span> <span class="p">{</span><span class="n">sum</span> <span class="o">+=</span> <span class="n">n</span><span class="p">;});</span>
</code></pre></div></div>

<h2 id="6-chevrons-intelligents">6) Chevrons intelligents</h2>

<p>Quand on manipule des templates, on peut maintenant écrire <code class="language-plaintext highlighter-rouge">std::map&lt;std::string, std::pair&lt;int, int&gt;&gt;</code> au lieu de <code class="language-plaintext highlighter-rouge">std::map&lt;std::string, std::pair&lt;int, int&gt; &gt;</code>.</p>

<p>Cela peut sembler être une amélioration mineure, mais qui n’a jamais été irrité par ces stupides espaces ?</p>

<h2 id="7-expressions-régulières">7) Expressions régulières</h2>

<p>Les expressions régulières sont maintenant fournies par la bibliothèque standard <code class="language-plaintext highlighter-rouge">&lt;regex&gt;</code>.</p>

<p>Voici un exemple montrant comment repérer un mot et un nombre dans une chaîne donnée:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cp">#include</span> <span class="cpf">&lt;regex&gt;</span><span class="cp">
</span>
<span class="n">std</span><span class="o">::</span><span class="n">regex</span> <span class="nf">myRegex</span><span class="p">(</span><span class="s">R"((\w+)=(\d+))"</span><span class="p">);</span>
<span class="n">std</span><span class="o">::</span><span class="n">string</span> <span class="nf">myStr</span><span class="p">(</span><span class="s">"n=42"</span><span class="p">);</span>
<span class="n">std</span><span class="o">::</span><span class="n">smatch</span> <span class="n">match</span><span class="p">;</span>
<span class="n">std</span><span class="o">::</span><span class="n">regex_match</span><span class="p">(</span><span class="n">myStr</span><span class="p">,</span> <span class="n">match</span><span class="p">,</span> <span class="n">myRegex</span><span class="p">);</span>
<span class="k">for</span> <span class="p">(</span><span class="n">std</span><span class="o">::</span><span class="n">string</span> <span class="n">s</span><span class="o">:</span> <span class="n">match</span><span class="p">)</span>
<span class="p">{</span>
    <span class="n">std</span><span class="o">::</span><span class="n">cout</span> <span class="o">&lt;&lt;</span> <span class="n">s</span> <span class="o">&lt;&lt;</span> <span class="n">std</span><span class="o">::</span><span class="n">endl</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<p>Ceci produit la sortie suivante:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>n=42
n
42
</code></pre></div></div>

<p>On notera au passage la nouvelle syntaxe de chaîne littérale <code class="language-plaintext highlighter-rouge">R"(...)"</code> qui permet d’éviter les doubles échappements <code class="language-plaintext highlighter-rouge">\\</code> (similaire à <code class="language-plaintext highlighter-rouge">r'...'</code> en Python par exemple).</p>

<h2 id="8-pointeurs-intelligents">8) Pointeurs intelligents</h2>

<p>La gestion correcte de la mémoire est un des aspects les plus complexes du C++, mais heureusement les pointeurs intelligents (<em>smart pointers</em>) sont là pour nous faciliter la vie.</p>

<p>Le principes des pointeurs intelligents est de s’assurer que les objets sont détruits automatiquement quand ils ne sont plus utilisés. Le C++11 a introduit deux types de pointeurs intelligents: <code class="language-plaintext highlighter-rouge">unique_ptr</code> et <code class="language-plaintext highlighter-rouge">shared_ptr</code> (et son frère jumeau le <code class="language-plaintext highlighter-rouge">weak_ptr</code>).</p>

<p><code class="language-plaintext highlighter-rouge">unique_ptr</code> est un remplacement d’<code class="language-plaintext highlighter-rouge">auto_ptr</code>, qui est maintenant déprécié car il peut être dangereux à utiliser. Un <code class="language-plaintext highlighter-rouge">unique_ptr</code> détient la propriété d’un pointeur, et comme le nom l’indique, un pointeur peut appartenir à un seul <code class="language-plaintext highlighter-rouge">unique_ptr</code> à un moment donné. Cependant, cette propriété peut être transférée explicitement à un autre <code class="language-plaintext highlighter-rouge">unique_ptr</code>, en utilisant la fonction <code class="language-plaintext highlighter-rouge">move</code>:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cp">#include</span> <span class="cpf">&lt;memory&gt;</span><span class="cp">
</span>
<span class="k">class</span> <span class="nc">Foo</span> <span class="p">{...};</span>

<span class="kt">void</span> <span class="n">bar</span><span class="p">()</span> 
<span class="p">{</span>
    <span class="n">std</span><span class="o">::</span><span class="n">unique_ptr</span><span class="o">&lt;</span><span class="n">Foo</span><span class="o">&gt;</span> <span class="n">myPtr</span><span class="p">(</span><span class="k">new</span> <span class="n">Foo</span><span class="p">);</span>
    <span class="n">myPtr</span><span class="o">-&gt;</span><span class="n">someMethod</span><span class="p">();</span>
    <span class="p">{</span>
        <span class="c1">// Transfère la propriété du pointeur</span>
        <span class="n">std</span><span class="o">::</span><span class="n">unique_ptr</span><span class="o">&lt;</span><span class="n">Foo</span><span class="o">&gt;</span> <span class="n">myOtherPtr</span> <span class="o">=</span> <span class="n">std</span><span class="o">::</span><span class="n">move</span><span class="p">(</span><span class="n">myPtr</span><span class="p">);</span>
        <span class="n">myOtherPtr</span><span class="o">-&gt;</span><span class="n">someMethod</span><span class="p">();</span>
        <span class="c1">// L'objet Foo est détruit automatiquement ici</span>
    <span class="p">}</span>
    <span class="c1">// Ne pas utiliser myPtr à partir d'ici !</span>
<span class="p">}</span>
</code></pre></div></div>

<p><code class="language-plaintext highlighter-rouge">shared_ptr</code>, emprunté a la bibliothèque <em>Boost</em>, est un pointeur à comptage de références: plusieurs instances de <code class="language-plaintext highlighter-rouge">shared_ptr</code> peuvent partager la propriété du même objet, et cet objet est détruit seulement quand la dernière référence vers celui-ci est détruite.</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cp">#include</span> <span class="cpf">&lt;memory&gt;</span><span class="cp">
</span>
<span class="k">class</span> <span class="nc">Foo</span> <span class="p">{...};</span>

<span class="kt">void</span> <span class="n">bar</span><span class="p">()</span> 
<span class="p">{</span>
    <span class="n">std</span><span class="o">::</span><span class="n">shared_ptr</span><span class="o">&lt;</span><span class="n">Foo</span><span class="o">&gt;</span> <span class="n">myPtr</span><span class="p">(</span><span class="k">new</span> <span class="n">Foo</span><span class="p">);</span>
    <span class="n">myPtr</span><span class="o">-&gt;</span><span class="n">someMethod</span><span class="p">();</span>
    <span class="p">{</span>
        <span class="c1">// Partage la propriété du pointeur</span>
        <span class="n">std</span><span class="o">::</span><span class="n">shared_ptr</span><span class="o">&lt;</span><span class="n">Foo</span><span class="o">&gt;</span> <span class="n">myOtherPtr</span> <span class="o">=</span> <span class="n">myPtr</span><span class="p">;</span>
        <span class="n">myOtherPtr</span><span class="o">-&gt;</span><span class="n">someMethod</span><span class="p">();</span>
    <span class="p">}</span>
    <span class="n">myPtr</span><span class="o">-&gt;</span><span class="n">someMethod</span><span class="p">();</span>
    <span class="c1">// L'objet Foo est détruit automatiquement ici</span>
<span class="p">}</span>
</code></pre></div></div>

<h2 id="9-support-des-threads">9) Support des <em>threads</em></h2>

<p>La STL en C++ contient une bibliothèque <code class="language-plaintext highlighter-rouge">&lt;thread&gt;</code>, avec tous les outils de base nécessaires au multi-threading: <em>threads</em>, <em>mutexes</em>, <em>lock guards</em>, et même <em>futures</em>.</p>

<p>Voici un petit exemple montrant commencer lancer un <em>thread</em> qui dort pendant <em>n</em> secondes:</p>

<div class="language-cpp highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cp">#include</span> <span class="cpf">&lt;iostream&gt;</span><span class="cp">
#include</span> <span class="cpf">&lt;chrono&gt;</span><span class="cp">
#include</span> <span class="cpf">&lt;thread&gt;</span><span class="cp">
</span>
<span class="kt">void</span> <span class="nf">foo</span><span class="p">(</span><span class="kt">int</span> <span class="n">n</span><span class="p">)</span> 
<span class="p">{</span>
    <span class="n">std</span><span class="o">::</span><span class="n">chrono</span><span class="o">::</span><span class="n">seconds</span> <span class="n">sec</span><span class="p">(</span><span class="n">n</span><span class="p">);</span>
    <span class="n">std</span><span class="o">::</span><span class="n">this_thread</span><span class="o">::</span><span class="n">sleep_for</span><span class="p">(</span><span class="n">sec</span><span class="p">);</span>
    <span class="n">std</span><span class="o">::</span><span class="n">cout</span> <span class="o">&lt;&lt;</span> <span class="s">"deux"</span> <span class="o">&lt;&lt;</span> <span class="n">std</span><span class="o">::</span><span class="n">endl</span><span class="p">;</span>
<span class="p">}</span>
 
<span class="kt">int</span> <span class="n">main</span><span class="p">()</span>
<span class="p">{</span>
    <span class="n">std</span><span class="o">::</span><span class="kr">thread</span> <span class="n">myThread</span><span class="p">(</span><span class="n">foo</span><span class="p">,</span> <span class="mi">5</span><span class="p">);</span>
    <span class="n">std</span><span class="o">::</span><span class="n">cout</span> <span class="o">&lt;&lt;</span> <span class="s">"un"</span> <span class="o">&lt;&lt;</span> <span class="n">std</span><span class="o">::</span><span class="n">endl</span><span class="p">;</span>
    <span class="n">myThread</span><span class="p">.</span><span class="n">join</span><span class="p">();</span>
<span class="p">}</span>
</code></pre></div></div>

<p>The programme affiche “un”, puis “deux” 5 secondes plus tard.</p>

<h2 id="10-tables-de-hachage">10) Tables de hachage</h2>

<p>Dans la STL, les <em>maps</em> et les <em>sets</em> sont implémentés avec des arbres binaires, qui sont des conteneurs ordonnés, ce qui permet de rechercher efficacement une clé dans un intervalle de valeurs.</p>

<p>Quand l’order n’est pas nécessaire, il est généralement plus efficace d’utiliser des tables de hachage à la place des arbres binaires (en moyenne, le complexité d’une recherche dans une table de hachage est en <em>O(1)</em>, alors qu’une recherche dans un arbre binaire est en <em>O(log n)</em>)</p>

<p>En C++11, les tables de hachages sont implémentées dans des nouveaux conteneurs: <code class="language-plaintext highlighter-rouge">unordered_map</code>, <code class="language-plaintext highlighter-rouge">unordered_set</code>, <code class="language-plaintext highlighter-rouge">unordered_multimap</code> and <code class="language-plaintext highlighter-rouge">unordered_multiset</code>.</p>

<h2 id="11-la-sémantique-de-déplacement">11) La sémantique de déplacement</h2>

<p>Le concept de déplacement (<em>move</em>) est une amélioration importante de C++11 pour simplifier l’écriture de programmes efficaces.</p>

<p>Avant le C++11, il était absolument déconseillé de passer comme valeur de retour d’une fonction des “gros” objets, par exemple un <code class="language-plaintext highlighter-rouge">vector</code> contenant beaucoup d’éléments.</p>

<p>En effet, dans le code suivant:</p>

<div class="language-c++ highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="n">std</span><span class="o">::</span><span class="n">string</span><span class="o">&gt;</span> <span class="n">foo</span><span class="p">()</span>
<span class="p">{</span>
    <span class="p">...</span>
    <span class="k">return</span> <span class="n">aBigVector</span><span class="p">;</span>
<span class="p">}</span>

<span class="n">std</span><span class="o">::</span><span class="n">vector</span><span class="o">&lt;</span><span class="n">std</span><span class="o">::</span><span class="n">string</span><span class="o">&gt;</span> <span class="n">myVector</span> <span class="o">=</span> <span class="n">foo</span><span class="p">();</span>
</code></pre></div></div>

<p>la fonction <code class="language-plaintext highlighter-rouge">foo()</code> renvoie un objet temporaire, qui est a priori copié dans la variable <code class="language-plaintext highlighter-rouge">myVector</code>, ce qui est une opération coûteuse. 
En réalité dans ce cas le compilateur peut effectuer une optimisation appelée RVO (<em>Return Value Optimization</em>), qui permet d’éviter une copie, mais cette optimisation est laissée au choix du compilateur et n’est pas garantie.</p>

<p>En C++11, un nouveau type de constructeur est apparu: le constructeur par déplacement, dont la signature est de la forme <code class="language-plaintext highlighter-rouge">vector(vector&amp;&amp; other)</code>.</p>

<p>La syntaxe <code class="language-plaintext highlighter-rouge">vector&amp;&amp;</code> désigne une référence <em>rvalue</em>, par opposition aux références habituelles (de type <code class="language-plaintext highlighter-rouge">vector&amp;</code>) qui sont des références <em>lvalue</em>. Les références <em>rvalue</em> sont utilisées pour référencer des objets temporaires, comme la valeur de retour dans la fonction <code class="language-plaintext highlighter-rouge">foo()</code> dans l’exemple précédent.</p>

<p>Le constructeur par déplacement prend donc en paramètre un objet temporaire, et le <em>déplace</em> dans un nouvel objet.
L’opération de déplacement transfère les données de l’ancien objet vers le nouveau, sans effectuer de copie.</p>

<p>Par exemple, un <code class="language-plaintext highlighter-rouge">vector</code> contient en interne un pointeur vers un tableau, qui lui contient les vraies données.
Quand on appelle le constructeur par copie de <code class="language-plaintext highlighter-rouge">vector</code>, les éléments du tableau sont copiés un à un (en appelant le constructeur de copie de chaque élément), ce qui peut être très pénalisant en termes de performance.</p>

<p>Avec le constructeur par déplacement, seul le <em>pointeur</em> vers le tableau interne est copié dans le nouvel objet, mais pas le tableau lui-même; l’opération est donc très rapide. Après un déplacement, l’ancien objet n’est pas détruit mais est en quelque sorte “vidé” de ses données, et devient donc inutilisable.</p>

<p>En C++11, le code <code class="language-plaintext highlighter-rouge">std::vector&lt;std::string&gt; myVector = foo();</code> appelle automatiquement le constructeur par déplacement s’il existe (ce qui est le cas pour <code class="language-plaintext highlighter-rouge">vector</code> et tous les conteneurs STL), au lieu du constructeur par copie.</p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[Le C++ a fait beaucoup de chemin depuis les années 1980, et beaucoup d’améliorations significatives ont été apportées au langage avec le standard C++11, sorti en 2011.]]></summary></entry><entry xml:lang="fr"><title type="html">Mesurer la complexité des programmes grâce au λ-calcul binaire</title><link href="https://cdeguet.net/blog/lambda-calcul-binaire/" rel="alternate" type="text/html" title="Mesurer la complexité des programmes grâce au λ-calcul binaire" /><published>2013-08-28T22:08:12+02:00</published><updated>2013-08-28T22:08:12+02:00</updated><id>https://cdeguet.net/blog/lambda-calcul-binaire</id><content type="html" xml:base="https://cdeguet.net/blog/lambda-calcul-binaire/"><![CDATA[<p>Le titre de cet article peut vous sembler bien mystérieux, mais ne soyez-pas effrayés, tout vous sera bientôt expliqué !</p>

<p>Dans l’<a href="/entropie-exergie-information/">article précédent</a> sur la notion d’exergie, je vous ai parlé de l’entropie de Shannon, qui permet de mesurer la quantité d’information d’une source de données. Pour rappel, l’entropie (mesurée en <em>bits</em>) d’une source pouvant prendre \(N\) valeurs possibles est donnée par la formule:</p>

\[H = - \sum_{i=1}^N P_i.log_2 P_i\]

<p>où \(P_i\) est la probabilité d’apparition de chaque valeur.</p>

<p>Dans le même ordre d’idées, on peut se demander quelle est la quantité d’information contenue dans un nombre, par exemple 1073741824. La notion d’entropie est ici inutilisable, car en dehors de tout contexte, ce nombre ne peut pas être associé à une probabilité. Il est cependant possible de compter la quantité de bits nécessaire pour représenter ce nombre en binaire, donnée par \(log_2 (1073741824) = 30\). En première approche, la quantité d’information dans 1073741824 serait donc de 30 bits. Cependant, si on remarque que \(1073741824 = 2^{30}\), on voit que ce nombre peut s’écrire sous une forme beaucoup plus simple, qui est simplement sa décomposition en facteurs premiers. D’une certaine façon, cette expression “\(2^{30}\)” est la représentation d’un algorithme qui s’écrirait en français “multiplier 30 fois par lui-même le nombre 2”.</p>

<p>Prenons maintenant un cas plus intéressant: le nombre \(\pi\) (3,14159…). Ce nombre possède une infinité de décimales à première vue aléatoires, et contient donc a priori une quantité d’information infinie, d’un point de vue numérique. Cependant de nombreux <a href="http://fr.wikipedia.org/wiki/Pi">algorithmes</a> existent pour calculer les <em>n</em> premières décimales de \(\pi\), donc l’information contenue dans \(\pi\) peut se résumer à la description de l’un de ces algorithmes. La question devient maintenant: quelle est la quantité d’information (en bits) de cet algorithme ? Le but de l’article est justement d’apporter une réponse à cette question !</p>

<p><img src="/blog/images/memoriserpi.jpg" alt="Pi" width="300px" /></p>

<p>On définit la <a href="http://fr.wikipedia.org/wiki/Complexit%C3%A9_de_Kolmogorov"><em>complexité de Kolmogorov</em></a> (du nom du mathématicien russe Андрей Колмогоров) d’un nombre comme étant la longueur du plus petit programme nécessaire pour calculer ce nombre. Un nombre complètement aléatoire ne peut être décrit par aucun programme plus court que le nombre lui-même, et possède donc une complexité de Kolmogorov maximale (on rejoint ici le concept d’entropie, qui est maximale quand les données sont aléatoires). La définition s’étend bien sûr à d’autres types de données, comme du texte. Par exemple il est clair que le texte “la la la la la la la la la la la la la la la la la la la la” contient assez peu d’information, résumée dans l’algorithme “écrire 20 fois le mot ‘la’”.</p>

<p>Cette définition est intéressante mais théorique, car d’une part il a été prouvé qu’il est impossible de trouver un algorithme permettant de calculer la complexité de Kolmogorov, et d’autre part elle ne dit pas vraiment comment calculer la longueur d’un programme. Il est clair que le choix du langage de programmation a une influence sur la longueur du programme minimal, mais on peut également prouver assez facilement (<a href="http://en.wikipedia.org/wiki/Kolmogorov_complexity#A_more_formal_treatment">théorème d’invariance</a>) que quelque soit le langage choisi, la complexité de Kolmogorov est la même, à une constante près.</p>

<p>Bien qu’il soit impossible de calculer de façon automatique la complexité de Kolmogorov d’un objet (nombre ou texte), on peut obtenir une borne supérieure de cette complexité si on arrive à trouver au moins <em>un</em> programme permettant de produire cet objet. Il ne reste plus qu’à trouver un langage de programmation suffisamment puissant pour écrire ce programme avec le moins de bits possible, pour s’approcher au plus près de la complexité de Kolmogorov. C’est dans cet objectif que John Tromp a mis au point le <a href="http://en.wikipedia.org/wiki/Binary_lambda_calculus">λ-calcul binaire</a>, qui est simplement une variante du λ-calcul.</p>

<p><img src="/blog/images/y_combinator.jpg" alt="Combinator" width="300px" /></p>

<p>Le <strong>λ-calcul</strong> (ou <a href="http://fr.wikipedia.org/wiki/Lambda-calcul">“lambda-calcul”</a>), est un formalisme inventé dans les années 1930 par le mathématicien Alonzo Church, bien avant l’apparition des premiers ordinateurs, et est l’ancêtre de tous les langages de programmation fonctionnelle (Lisp, Haskell, Clojure, etc.). La puissance du λ-calcul vient du fait qu’il permet d’écrire n’importe quel programme, à partir d’une syntaxe extrêmement simple. En λ-calcul, tout programme est une <em>expression</em>, qui ne peut être que l’une des 3 formes suivantes:</p>

<ol>
  <li>Une <em>variable</em>, de la forme x, y, z ou n’importe quelle autre lettre</li>
  <li>Une <em>abstraction</em>, de la forme (λx.a), où x est une variable et a est une autre expression</li>
  <li>Une <em>application</em>, de la forme (a b), où a et b sont deux autres expressions</li>
</ol>

<p>Et voilà c’est tout ! Mais alors, comment écrire un programme en λ-calcul ? Pour cela, il faut d’abord comprendre quelle est la signification de ces différentes formes.</p>

<p>Une <em>abstraction</em> (λx.a) est en fait simplement la définition d’une fonction, qui prend la variable x en paramètre, et renvoie l’expression a. Par exemple l’expression (λx.x) correspond à la définition de la fonction “identité”, qui renvoie toujours sa valeur d’entrée. L’expression (λx.y) définit la fonction “constante y”, qui renvoie toujours y quelque que soit la valeur d’entrée</p>

<p>Une <em>application</em> (a b) correspond en fait à un appel de fonction, et sa valeur est le résultat de la fonction a appliquée au paramètre b (en mathématiques on écrirait plutôt “a(b)”). </p>

<p>Le cœur du λ-calcul est la règle suivante, dite de β-réduction, qui permet de calculer le résultat d’une application: (λx.a b) = a[x := b]. En français, cette règle signifie: “Le résultat de l’application de la fonction (λx.a) à l’expression b est égal à l’expression a dans laquelle on a remplacé toutes les occurences de la variable x par l’expression b”. Cette règle en apparence complexe est en fait ce qu’on fait tous les jours en mathématiques: par exemple si on a une fonction f définie par “f(x) = x+2”, l’application de f au nombre 4 se calcule par “f(4) = 4+2 = 6”; on a simplement remplacé x par 4 dans la définition de f. En λ-calcul, la fonction f s’écrirait “(λx.(+ x 2))”, et le calcul s’écrit: “((λx.(+ x 2)) 4) = 6)”. Attention, on écrit bien “+ x 2” et non pas “x + 2”, car la fonction à appliquer doit toujours apparaître en premier dans une expression (on parle de <em>notation préfixe</em>). A noter que le nom des variables n’a pas d’importance, on peut tout aussi bien écrire la fonction f comme “(λy.(+ y 2))”.</p>

<p>Comme cette notation introduit beaucoup de parenthèses, on prend également quelques conventions pour simplifier l’écriture: </p>

<ul>
  <li>(a b c) = ((a b) c)</li>
  <li>a b = (a b)</li>
  <li>λa.b c = (λa.(b c))</li>
</ul>

<p>Avec ces conventions, le calcul précédent s’écrit plus simplement “(λx.+ x 2) 4 = 6”.</p>

<p>Dernier détail: une fonction à deux variables peut s’écrire sous la forme λx.λy.a, une fonction à trois variables λx.λy.λz.a, etc.</p>

<p>Croyez-le ou non, avec ces quelques règles il est possible d’écrire n’importe quel programme !</p>

<p>Par exemple on définit la constante logique “VRAI” par l’expression “λx.λy.x”, qui est une fonction qui prend deux variables x et y en paramètre, et renvoie toujours x. De même on définit la constante “FAUX” par “λx.λy.y”, et l’opérateur logique “ET” par “λx.λy.y x y”. Avec ces conventions, on peut vérifier par exemple que “ET VRAI FAUX = FAUX”, grâce à la règle de β-réduction. Allons-y !</p>

<ul>
  <li>ET VRAI FAUX = (λx.λy.y x y) VRAI FAUX = FAUX VRAI FAUX = (λx.λy.y) VRAI FAUX = FAUX</li>
</ul>

<p>De la même façon on vérifie facilement que “ET VRAI VRAI = VRAI”:</p>

<ul>
  <li>ET VRAI VRAI = (λx.λy.y x y) VRAI VRAI = VRAI VRAI VRAI = (λx.λy.y) VRAI VRAI =VRAI</li>
</ul>

<p>Remarquez que j’ai utilisé dans les exemples précédents des nombres entiers et l’opérateur +, alors que ceux-ci ne sont absolument pas définis par le λ-calcul. Bien sûr il est difficile d’écrire des programmes sans pouvoir utiliser les nombres entiers… Church a donc imaginé une façon de définir les nombres dans le λ-calcul:</p>

<ul>
  <li>0 := λx.λy.y</li>
  <li>1 := λx.λy.x y</li>
  <li>2 := λx.λy.x (x y)</li>
  <li>3 := λx.λy.x (x (x y))</li>
  <li>n+1 := λx.λy.x (n x y)</li>
</ul>

<p>Comme les opérateurs logiques, les nombres sont donc définis par des fonctions à deux variables. On remarque d’ailleurs que 0 = FAUX, ce qui est assez logique et habituel dans les langages de programmation. Avec cette convention, l’addition se définit par:</p>

<ul>
  <li>+ := λa.λb.λx.λy.a x (b x y)</li>
</ul>

<p>Avec ces définitions (bien compliquées), on peut vérifier que 2+1 = 3:</p>

<ul>
  <li>+ 2 1 = (λa.λb.λx.λy.a x (b x y)) 2 1 = λx.λy.2 x (1 x y) = λx.λy.x (x (1 x y)) = λx.λy.x (x (x y)) = 3</li>
</ul>

<p>Ouf ! De la même façon on peut définir toutes les structures de données et de contrôle utilisées habituellement en programmation: paires, ensembles, listes, boucles, récursivité, tests, etc. !</p>

<p><img src="/blog/images/binary-number-tunnel-1080p-hd-wallpaper.jpg" alt="Tunnel" width="356px" /></p>

<p>Le λ-calcul est donc un langage de programmation qui permet d’écrire n’importe quel algorithme, mais pour en revenir au but initial, comment peut-on mesurer la longueur en bits d’un programme λ-calcul ? Il s’agit de trouver un codage pour écrire une expression en binaire, de la façon la plus efficace possible.</p>

<p>La première chose à faire est d’utiliser la notation des <a href="http://en.wikipedia.org/wiki/De_Bruijn_index"><em>index de De Bruijn</em></a>, qui consiste à remplacer les noms de variable par des nombres. Dans une fonction à n variables, la première variable est notée 1, la deuxième variable est notée 2, etc. Il faut également rétablir les parenthèses, pour ne garder que des applications de la forme (a b).</p>

<p>Par exemple la fonction “identité” λx.x s’écrit simplement “λ1”, le nombre 1 (λx.λy.x y) s’écrit “λλ(1 2)”, l’opérateur + (λa.λb.λx.λy.a x (b x y)) s’écrit “λλλλ(1 (3 ((2 3) 4)))”, etc.</p>

<p>La deuxième étape est de convertir l’expression en binaire, grâce au codage suivant:</p>

<ul>
  <li>λa = 00 a’   (où a’ est le codage binaire de l’expression a)</li>
  <li>(a b) = 01 a’ b’</li>
  <li>1 = 10</li>
  <li>2 = 110</li>
  <li>3 = 1110</li>
  <li>etc.</li>
</ul>

<p>Avec ce codage, l’identité (λ1) devient donc “00 10”, le nombre 1 (λλ(1 2)) devient “00 00 01 10 110”, et l’opérateur + (λλλλ(1 (3 ((2 3) 4))) devient “00 00 00 00 01 10 01 1110 01 01 110 1110 11110”.</p>

<p>Si on utilise les nombres de Church, on peut montrer que l’opérateur “exposant” (\(x^y\)) s’écrit tout simplement λx.λy.y x, autrement dit λλ(2 1), qui se code en “00 00 01 110 10”. Grâce au λ-calcul binaire, on peut donc coder l’algorithme “exposant” en seulement 11 bits. L’opérateur \(x^{x^x}\), qui s’écrit λx.x x x, se code lui en “00 01 10 01 10 10”, soit 12 bits.</p>

<p>Prenons maintenant le nombre 1 suivi de 10 milliards de zéro. Ce nombre gigantesque peut s’écrire \(10^{10^{10}}\), et est donc le résultat de l’opérateur \(x^{x^x}\) appliqué à 10. On peut montrer que le nombre 10 s’écrit avec 47 bits en λ-calcul binaire, donc le programme qui permet de calculer \(10^{10^{10}}\) a une longueur de 2+47+12=61 bits, alors que si on écrit simplement \(10^{10^{10}}\) en binaire, on obtient un nombre de plus de 332 milliards de bits !</p>

<p>La complexité de Kolmogorov de \(10^{10^{10}}\) est donc au maximum de 61 bits; il resterait à prouver qu’il n’existe pas d’algorithme plus efficace (en utilisant le λ-calcul) pour calculer ce nombre, pour montrer que la complexité est exactement égale à 61 bits.</p>]]></content><author><name></name></author><category term="fr" /><summary type="html"><![CDATA[Le titre de cet article peut vous sembler bien mystérieux, mais ne soyez-pas effrayés, tout vous sera bientôt expliqué !]]></summary></entry><entry xml:lang="fr"><title type="html">Entropie, exergie et information</title><link href="https://cdeguet.net/blog/entropie-exergie-information/" rel="alternate" type="text/html" title="Entropie, exergie et information" /><published>2013-08-05T21:54:34+02:00</published><updated>2013-08-05T21:54:34+02:00</updated><id>https://cdeguet.net/blog/entropie-exergie-information</id><content type="html" xml:base="https://cdeguet.net/blog/entropie-exergie-information/"><![CDATA[<p>Pour ce premier article, j’ai décidé de parler d’une notion assez peu connue du grand public: l’<strong>exergie</strong>, et de son lien avec l’informatique.</p>

<p>L’exergie est une grandeur thermodynamique, liées aux notions d’<em>énergie</em> et d’<em>entropie</em>. Il en existe plusieurs définitions, mais la plus intuitive est la suivante: “l’exergie d’un système est le travail utile maximal que peut fournir ce système dans un environnement donné”. Le point important est que l’exergie est définie par rapport à l’environnement, contrairement à l’énergie qui est une grandeur intrinsèque du système. Dit autrement, l’exergie est une mesure du déséquilibre d’un système avec son environnement: un système en équilibre avec son environnement ne peut fournir aucun travail utile, son exergie est donc nulle. L’exergie s’exprime en Joules (J), tout comme l’énergie.</p>

<p>Un exemple pour comprendre: une casserole d’eau à température ambiante de 20°C possède une certaine énergie interne (proportionnelle à la température), mais son exergie est nulle car l’eau est en équilibre thermique avec l’environnement, et son énergie est donc inutilisable. Une casserole chauffée à 100°C possède, elle, une exergie (énergie utilisable) capable de faire cuire un oeuf ou de réchauffer - un peu - la cuisine. La même casserole placée dans un four déjà chauffé à 100°C aurait la même énergie, mais par contre une exergie nulle, car elle serait cette fois en équilibre avec son environnement. On comprend avec cet exemple que l’exergie a une utilité pratique beaucoup plus importante que l’énergie, bien que cette notion soit beaucoup moins connue. On comprend également que l’exergie peut se <em>détruire</em>: si on laisse la casserole se refroidir, l’énergie totale de la cuisine ne change pas, mais son exergie totale diminue car l’eau de la casserole et l’air de la cuisine se rapprochent de leur état d’équilibre.</p>

<p><img src="/blog/images/Boiling-Water.jpg" alt="Boiling Water" width="400px" /></p>

<p>Autre exemple: le chauffage électrique. L’électricité est de l’exergie pure, car l’énergie électrique est théoriquement entièrement récupérable en travail (par exemple dans un moteur électrique sans aucun frottement). Dans un radiateur électrique, cette énergie est convertie en chaleur, utilisée pour réchauffer l’air de la pièce. Par contre une grande partie de cette énergie est “perdue” car si l’air chaud de la pièce devait être utilisé dans un moteur thermique pour produire de l’énergie, seule une petite partie (en pratique moins de 10%) de l’énergie de départ pourrait être récupérée. Plus de 90% de l’exergie de l’électricité a donc été définitivement perdue dans l’opération. Et le problème n’est pas que les technologies actuelles ne permettent pas de récuperer toute l’énergie de l’air chaud; c’est en fait une limitation théorique due à la nature même de l’énergie thermique. On a coutume de dire que le chauffage électrique a un rendement <em>énergétique</em> de 100%, ce qui est vrai puisque toute l’énergie électrique dépensée dans le radiateur est récupérée en énergie thermique, mais par contre le rendement <em>exergétique</em> est extrêmement mauvais.</p>

<p>Vous me direz: très bien mais quel rapport avec l’informatique ? J’y viens. L’exergie est en fait directement liée à la notion d’<em>entropie</em> qui est, elle, bien plus connue. En thermodynamique, l’entropie d’un système est une mesure de son degré de désordre; elle ne peut qu’augmenter si le système est isolé (second principe de la thermodynamique) et atteint son maximum lorsque le système est dans son état d’équilibre. Si \(T_0\) est la température de l’environnement, \(S^{tot}\) l’entropie totale du système et de l’environnement, et \(S^{tot}_{eq}\) l’entropie totale quand le système est à l’équilibre avec l’environnement, on peut montrer que l’exergie du système s’exprime par:</p>

\[B = T_0 (S^{tot}_{eq} - S^{tot})\]

<p>Cette relation montre bien que l’exergie est une mesure du déséquilibre entre le système et son environnement, et diminue à mesure que l’entropie augmente. Mais cette relation devient encore plus intéressante si on regarde de plus près la définition de l’entropie. Comme l’a montré Boltzmann, si un système peut prendre \(W\) états possibles, avec une probabilité \(P_i\) de se trouver dans l’état \(i\), alors l’entropie est égale à</p>

\[S = - k \sum_{i=1}^W P_i.ln P_i\]

<p>où k est la constante de Boltzmann (\(1,381.10^{-23}J.K^{-1}\)). On considère que lorsque le système est à l’équilibre, tous les états sont equiprobables, et alors l’entropie devient maximale et égale à \(S = k.ln W\).</p>

<p>Le lien avec l’informatique commence à apparaître si on remarque que la définition de l’entropie donnée par Boltzmann ressemble beaucoup à une autre formule découverte par Shannon 75 ans plus tard:</p>

\[H = - \sum_{i=1}^N P_i.log_2 P_i\]

<p>Cette formule donne la quantité d’information contenue dans une source quelconque de données, pouvant prendre \(N\) valeurs (états) possibles, avec une probabilité \(P_i\) pour chaque valeur. Le nombre \(H\) s’exprime en <em>bits</em>, et s’appelle l’entropie de Shannon, par analogie. Si les valeurs sont équiprobables, la formule devient \(H = log_2 N\), ce qui est assez logique car une information aléatoire représentée par \(n\) bits peut prendre \(N=2^n\) valeurs possibles. Si les valeurs ne sont pas équiprobables, alors il est possible de <em>compresser</em> les données, et l’entropie de Shannon permet de calculer le nombre minimal de bits théoriquement requis pour coder l’information sans perte de données.</p>

<p>Et que devient l’exergie dans tout ça ?  Si on combine les équations précédentes, on montre que l’exergie peut s’exprimer par:</p>

\[B = k.T_0.ln2.H\]

<p>où \(H\) est la quantité d’information (en <em>bits</em>) nécessaire pour décrire l’écart entre l’état du système et son état d’équilibre. Cette relation fait donc un lien entre la théorie de l’information et la thermodynamique ! Ce lien peut sembler purement formel et abstrait, mais on peut le comprendre intuitivement si on considère que l’information doit toujours à un moment ou à un autre être représentée par un support physique.</p>

<p>Si on applique cette formule, une exergie de 1 Joule à température ambiante de 20°C correspond à une quantité d’information de \(3,6.10^{20}\) bits ! Pour donner un élément de comparaison, une mémoire flash permet au mieux d’écrire 10 Gbit de données avec 1 Joule d’énergie; on est donc encore très loin du maximum théorique. D’un autre côté, la réplication de l’ADN dans les cellules permet de copier de l’ordre de \(2.10^{19}\) bits d’information par Joule consommé, ce qui extrêmement proche de la limite théorique ! En matière de consommation d’énergie (ou plutôt, d’exergie), la vie est bien plus efficace que les ordinateurs…</p>]]></content><author><name></name></author><category term="fr" /><category term="entropie" /><category term="exergie" /><summary type="html"><![CDATA[Pour ce premier article, j’ai décidé de parler d’une notion assez peu connue du grand public: l’exergie, et de son lien avec l’informatique.]]></summary></entry></feed>